Введение
Агент из первой части умеет только запрашивать алерты. В первой попытке я дал ему один инструмент поиска по индексу soc-knowledge, и ответил он почти правильно: на вопрос, что предписывает плейбук при SSH-переборе против web-server-01, нашел в индексе нужный документ, назвал правила и владельца и пропустил блокировку на 12 часов. Из пяти найденных фрагментов к плейбуку относился только один, и о блокировке в нем не было ни слова.
Чтобы такой ответ стал невозможным, нужны две вещи. Документы должны попадать в индекс целиком и с метаданными, по которым найденный фрагмент можно привязать к своему файлу; агент должен уметь по этим метаданным дочитать файл до конца. В индекс soc-knowledge внутри Wazuh Indexer для этого попали сами плейбуки, руководство пользователя Wazuh 4.14 с описанием правил и active response, MITRE ATT&CK в том виде, в каком его отдает менеджер Wazuh, и закрепленный набор OSINT-событий MISP для вопросов про индикаторы. Всего 7118 документов, и у каждого есть вектор из 1024 чисел, который Indexer получает сам через коннектор ML Commons к Amazon Titan Text Embeddings V2. Загрузчик отправляет только текст. Дочитывать документ агент будет вторым инструментом, SearchIndexTool, а искать - тем же VectorDBTool, что и при первой попытке.

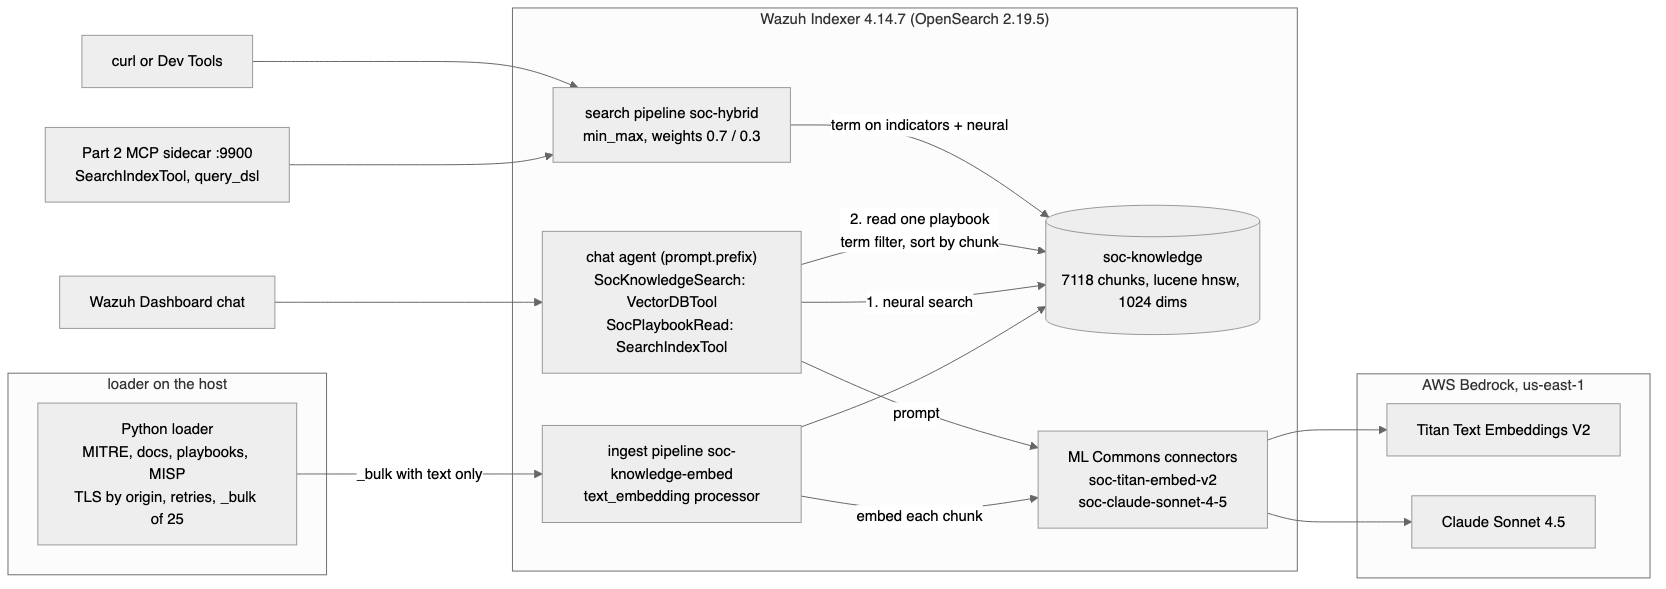
Схема установки, на которой сделаны измерения (это диаграмма, а не снимок экрана): индекс знаний, коннектор векторной модели, чат-агент с инструментами поиска и чтения, MCP-сайдкар и прямой путь запроса
В серии четыре части.
- Часть 1 - ML Commons, коннектор Bedrock Claude и чат-агент в Dashboard
- Часть 2 -
opensearch-mcp-server-pyкак сайдкар и Claude Desktop поверх MCP - Часть 3 (эта статья) - Titan Embeddings V2, lucene k-NN индекс по четырем источникам и гибридный поиск
- Часть 4 - те же четыре источника в Amazon S3 Vectors через Bedrock Knowledge Bases и сравнение с индексом внутри Indexer
Результаты собраны за три дня.
- 2026-09-02 - падение узла на движке
faissи первый гибридный запрос по индикатору на предыдущей сборке индекса, пересобранного на следующий день. - 2026-09-03 - сборка индекса: прерванный запуск, затем две завершенные полные загрузки; первая попытка агента с одним поисковым инструментом.
- 2026-09-04 - проверка агента, примеры запросов, два отрицательных контроля, расчет стоимости и повторный гибридный запрос с другим хешем.
Полной независимой воспроизводимости статья не обещает. При повторной сборке должны совпасть количества документов документации и плейбуков, потому что их источники закреплены; число документов MITRE повторится там, где менеджер отдает тот же набор, mitre_version 2.0 на 4.14.7. Оценки поиска совпадать не обязаны: они зависят от векторов, посчитанных в конкретный день. Может измениться и число фрагментов MISP: для этого источника закреплен только список UUID, поэтому отредактированное или отозванное событие сдвинет итог. Падение на faiss датировано только 2026-09-02 и воспроизведено только в одноразовом индексе, а не в рабочем: повторить его позже значило бы уронить узел, на котором уже собран рабочий индекс и к которому привязан чат. Для каждого результата в соответствующем разделе указано, как он получен.
Окружение
- Стек первой части: Docker и Docker Compose v2,
wazuh-dockerв варианте single-node с уже сгенерированными сертификатами Indexer, не меньше 8 ГБ памяти под Docker. - Версии: первая часть написана на Wazuh 4.14.3, измерения для третьей части сделаны на 4.14.7 с OpenSearch 2.19.5 и ML-плагинами 2.19.5.0.
- Плагины Indexer:
opensearch-skillsиopensearch-flow-framework2.19.5.0 из Maven;opensearch-knn,opensearch-mlиopensearch-neural-searchтой же версии уже есть в образе. - Плагины Dashboard: три плагина из дистрибутива OpenSearch Dashboards 2.19.5.
- AWS: доступ к моделям
amazon.titan-embed-text-v2:0иus.anthropic.claude-sonnet-4-5-20250929-v1:0в вашем регионе и правоbedrock:InvokeModelна обе; регион в статье вездеus-east-1. Ключи из именованного профиля AWS CLI процесс регистрации коннектора читает командойaws configure export-credentials; после его завершения файла с ключами не остается. - Коннектор и модель Claude из первой части регистрируются без изменений; их проверка с параметром
promptпроходит.
В командах первой части меняются только номера версий.
mkdir -p config/wazuh_indexer/plugins
cd config/wazuh_indexer/plugins

curl -L -O https://repo1.maven.org/maven2/org/opensearch/plugin/opensearch-flow-framework/2.19.5.0/opensearch-flow-framework-2.19.5.0.zip
curl -L -O https://repo1.maven.org/maven2/org/opensearch/plugin/opensearch-skills/2.19.5.0/opensearch-skills-2.19.5.0.zip

mkdir -p opensearch-flow-framework opensearch-skills
unzip opensearch-flow-framework-2.19.5.0.zip -d opensearch-flow-framework/
unzip opensearch-skills-2.19.5.0.zip         -d opensearch-skills/
rm -f *.zip

cd ../../..
curl https://artifacts.opensearch.org/releases/bundle/opensearch-dashboards/2.19.5/opensearch-dashboards-2.19.5-linux-x64.tar.gz -o opensearch-dashboards.tar.gz
tar -xzf opensearch-dashboards.tar.gz

mkdir -p config/wazuh_dashboard/plugins
cp -r opensearch-dashboards-2.19.5/plugins/observabilityDashboards config/wazuh_dashboard/plugins/
cp -r opensearch-dashboards-2.19.5/plugins/mlCommonsDashboards     config/wazuh_dashboard/plugins/
cp -r opensearch-dashboards-2.19.5/plugins/assistantDashboards     config/wazuh_dashboard/plugins/

rm -rf opensearch-dashboards-2.19.5* opensearch-dashboards.tar.gz
Что именно увидела модель в первом результате
Блокировка на 12 часов, которой не хватило в первом ответе, есть только в одном месте, в плейбуке, написанном для этой статьи, и в этом вся ценность плейбуков как проверки: правильный ответ по MITRE или по руководству Wazuh модель могла дать по памяти, эти тексты опубликованы. Вместе с блокировкой в ответе должны быть названы эскалация, которую плейбук требует при успешном входе после серии отказов, и номера двух правил, за которые отвечает плейбук именно этого хоста. Придуманы здесь только срок блокировки и условия эскалации (в рабочем SOC они свои); остальное, номера правил и способ блокировки, взято из Wazuh.
Вот сам документ; в индексе он разбит на шесть фрагментов: фрагмент 0 - строка Scope под заголовком H1, остальные пять - по одному на раздел H2, каждый с заголовком своего раздела.
# Playbook: SSH brute force against web-server-01

Scope: agent web-server-01 (Ubuntu 24.04, internet-facing). Applies to Wazuh rule 5712 (SSH brute force against a non-existent user) and rule 5763 (SSH brute force with failed authentication). Owner: SOC tier 1. Escalate to tier 2 when containment fails or when a successful login follows the burst.

## Detection

Read the alert fields data.srcip, data.dstuser and rule.frequency. Eight matches from one source within 120 seconds trigger rule 5712 when the failures target a non-existent user, or rule 5763 for failed authentication. If a successful login from the same address follows either burst within two minutes, preserve the authentication evidence, contain the source and escalate to tier 2. Never close the sequence as benign based on the success alone.

## Triage

Check whether data.srcip belongs to the corporate VPN range 10.20.0.0/16 or to a known scanner. Query the alert store for the same source across all agents for the last 24 hours. If the address hits more than one host, open a campaign ticket instead of a single-host ticket.

## Containment

Block the source address on the host firewall of web-server-01 with the active response firewall-drop for 12 hours. Confirm the action in /var/ossec/logs/active-responses.log and verify the firewall state on the endpoint. A zero count of later alerts is supporting evidence only, because the source may have stopped sending traffic. Do not disable the sshd service.

## Escalation

Escalate to tier 2 if any of the following hold: a successful login from the blocked address before the block, more than three hosts targeted by the same address, or a user account that is not in the expected administrator list.

## Closure

Record the source address, the number of failures, the block time and the ticket id in the case. Close within one business day if no escalation criterion was met.
И при первой попытке, и в запуске 2026-09-04, ответ из которого приведен в разделе об агенте, ближайшим к вопросу оказался фрагмент 0, строка Scope под заголовком; во втором случае его оценка 0.866. В нем есть оба правила и владелец, но нет ни слова о блокировке: она описана в разделе Containment, фрагменте 3 того же файла. Пока агент получал только результат поиска, для этого вопроса все, что лежит ниже строки Scope, включая Containment, до модели не доходило.
Два заимствования из Wazuh легко проверить. Порог в восемь совпадений за 120 секунд стоит в SSH-правилах Wazuh 4.14.7, где определены правила 5712 и 5763. Блокировку через firewall-drop показывает сценарий active response для SSH-перебора; в его примере она длится 180 секунд. У трех других плейбуков по шесть фрагментов, как у этого. Один сопоставлен правилам 550 и 553 и описывает изменение sshd_config, другой - правилу 100450 и запуску оболочки процессом веб-сервера, а третий берет любой алерт уровня 12 и выше и, если для случая есть свой плейбук, отправляет к нему по имени.
Откуда 7118 документов
Число в заголовке складывается из четырех источников, загруженных 2026-09-03: 1031 документ MITRE, 3854 фрагмента документации из 316 файлов, 24 фрагмента плейбуков из 4 файлов и 2209 фрагментов MISP из 200 событий. У каждого источника есть правило отбора, по которому его можно загрузить заново.
- MITRE ATT&CK. Закреплять нечего, кроме самого менеджера: 750 техник, 267 мер противодействия и 14 тактик при
mitre_version2.0 приходят через API менеджера Wazuh, из его собственной базы MITRE. Из техники получается документ с именем, идентификатором, описанием, тактиками, рекомендациями по обнаружению и названиями мер. Отдельными документами становятся и мера противодействия, и тактика: 750 + 267 + 14 = 1031. - Документация Wazuh. Закреплен коммит
e3296ddветки4.14: на нем взят и перечень файлов.rstподsource/user-manual/, и их содержимое, 316 файлов. Без закрепленного коммита число 3854 не повторить: правка, которая добавляет или убирает секцию или меняет ее длину, меняет и нарезку, потому что границы секций задают подчеркивания заголовков RST, а от секций зависит разбиение на фрагменты. - Плейбуки. Закреплены сами файлы: четыре файла Markdown, написанные для этой статьи и разбитые по заголовкам H1 и H2; их темы названы в разделе о первом результате.
- MISP. Закреплен только список: 200 UUID событий, снятые с манифеста публичного фида CIRCL OSINT 2026-09-02 (тогда манифест перечислял 1680 событий). Сами события по этому списку скачиваются заново при каждом запуске, поэтому число их фрагментов, 2209, закреплено слабее остальных. В поле
indicatorsуходят хеши, домены, адреса и URL события, в текст - строкаinfoи атрибуты comment и text.
Идентификатор документа считается как sha1(source, doc_id, chunk), поэтому два документа одного источника с одинаковым doc_id слились бы в один, и при записи через bulk upsert в индексе остался бы поздний. Для MITRE это не гипотеза: на этой установке 224 из 267 мер противодействия приходят с external_id в форме T-номера техники. Отсюда префикс типа в doc_id мер и тактик, mitigation:T1081 и tactic:TA0003; техники остаются с T-номером без префикса.
Перед отправкой загрузчик делает с текстом фрагмента документации или плейбука две вещи: ставит впереди заголовок его секции, а если и с заголовком текст разбирается как JSON, добавляет префикс Excerpt:. Зачем, видно по ошибке поискового инструмента в разделе про агента.
Идентификатор документа вычисляется из данных, а не из момента запуска, поэтому второй полный запуск обязан лечь ровно на те же _id. Это свойство я проверил двумя завершенными полными загрузками за один день (о прерванном запуске перед ними сказано в разделе о поломках). Признаком сбоя стал бы идентификатор, который есть в одном из двух списков, снятых через Scroll API после каждого завершившегося запуска, и отсутствует в другом. Повторов _id и повторов тройки (source, doc_id, chunk) в списках нет, а сами списки, по 7118 строк каждый, совпали побайтно.
Индекс, пайплайны и размер фрагмента
Проба токенизации: одна страница руководства объемом 150 КБ, source/user-manual/reference/internal-options.rst, ее префиксы нарастающей длины и поле inputTextTokenCount в ответе bedrock-runtime на каждый из них.
| Префикс, символов | Токенов | Символов на токен |
|---|---|---|
| 2000 | 401 | 4,99 |
| 4000 | 612 | 6,54 |
| 8000 | 994 | 8,05 |
| 12000 | 1342 | 8,94 |
| 16000 | 1714 | 9,33 |
| 24000 | 2389 | 10,05 |
| 32000 | 3121 | 10,25 |
| 40000 | 3844 | 10,41 |
| 44000 | 4218 | 10,43 |
| 48000 | 4582 | 10,48 |
Размер фрагмента взят из самой плотной строки таблицы: при 4,99 символа на токен фрагмент в 3000 символов дает около 600 токенов (перекрытие соседних фрагментов - 200 символов), с большим запасом до предела Titan V2, который руководство Amazon Bedrock задает как 8192 токена или 50000 символов. Почему не считать по среднему: то же руководство называет для английской прозы 4,7 символа на токен, а по таблице одна страница reStructuredText с директивами, таблицами и блоками кода доходит до 10,48, и оценка по среднему соотношению всей страницы на ее плотных участках занизила бы число токенов вдвое. Titan V2 не отклонил ни один префикс из таблицы. Перед созданием индекса загрузчик проверяет, что четыре таких фрагмента занимают не больше 48000 символов - длины самого большого префикса, который принял Titan V2.
В маппинге единственного индекса, общего для четырех источников, кроме векторного поля есть поля keyword: indicators и source участвуют в поисковых запросах (о них речь сразу после блока), doc_id и version отбирают конкретный документ, когда агент дочитывает плейбук, а version еще и отбирает поколение документов; url нужен, чтобы результат можно было процитировать.
PUT /soc-knowledge
{
  "settings": {
    "index": {
      "knn": true,
      "number_of_shards": 1,
      "number_of_replicas": 0,
      "search.default_pipeline": "soc-hybrid"
    }
  },
  "mappings": {
    "properties": {
      "source": { "type": "keyword" },
      "doc_id": { "type": "keyword" },
      "chunk": { "type": "integer" },
      "title": { "type": "text" },
      "text": { "type": "text" },
      "text_embedding": {
        "type": "knn_vector",
        "dimension": 1024,
        "method": {
          "name": "hnsw",
          "engine": "lucene",
          "space_type": "cosinesimil",
          "parameters": { "ef_construction": 128, "m": 16 }
        }
      },
      "indicators": { "type": "keyword" },
      "url": { "type": "keyword" },
      "version": { "type": "keyword" },
      "ingested_at": { "type": "date" }
    }
  }
}
Два поля keyword, indicators и source, дают то, чего векторный поиск не умеет: точное совпадение и отбор по корпусу. В indicators лежит то, о чем оператор спрашивает дословно: у техники MITRE ее T-номер, у плейбука номера правил Wazuh в форме rule-5712, у события MISP хеши, адреса, домены и URL. Запрос term по этому полю либо находит значение целиком, либо не находит ничего, и на этом построен гибридный запрос в разделе о запросах. Поле source нужно для вопросов, у которых ответ заведомо в одном корпусе: запрос neural по одним плейбукам в том же разделе отличается от запроса по всему индексу только фильтром term по source.
Пайплайн soc-hybrid состоит из одного процессора нормализации. Он получает два списка оценок, от точной части запроса и от векторной, приводит каждый через min_max к диапазону от 0 до 1 и складывает их с весами 0.7 и 0.3. Откуда именно такие веса, показывает арифметика в разделе о запросах; страница документации о процессоре накладывает на них два ограничения: в сумме они дают 1.0, и их столько же, сколько подзапросов. Пайплайн записан в настройку индекса index.search.default_pipeline, поэтому параметр search_pipeline клиентам не нужен, а веса всегда берутся из пайплайна; что это дает сайдкару из второй части, сказано в разделе о запросах.
PUT /_search/pipeline/soc-hybrid
{
  "description": "Hybrid: exact indicators plus semantic text",
  "phase_results_processors": [
    {
      "normalization-processor": {
        "normalization": { "technique": "min_max" },
        "combination": {
          "technique": "arithmetic_mean",
          "parameters": { "weights": [0.7, 0.3] }
        }
      }
    }
  ]
}
Ingest-пайплайн короче: один процессор text_embedding, который кладет вектор поля text в text_embedding; пробный документ, пропущенный через него, получил вектор из 1024 чисел.
PUT /_ingest/pipeline/soc-knowledge-embed
{
  "description": "Embed the text field with Titan Text Embeddings V2",
  "processors": [
    {
      "text_embedding": {
        "model_id": "<titan_model_id>",
        "field_map": { "text": "text_embedding" }
      }
    }
  ]
}
Прежде чем процессор сможет сослаться на модель, нужно зарегистрировать коннектор Titan, а затем саму модель. Тело коннектора повторяет схему из репозитория ML Commons; две функции bedrock.embedding в нем оттуда же, и без них ответ Titan не лег бы в формат text-embedding, которого ждут пайплайн и запрос neural.
POST /_plugins/_ml/connectors/_create
{
  "name": "soc-titan-embed-v2",
  "description": "Amazon Titan Text Embeddings V2 for the SOC knowledge index",
  "version": 1,
  "protocol": "aws_sigv4",
  "credential": {
    "access_key": "<AWS_ACCESS_KEY_ID>",
    "secret_key": "<AWS_SECRET_ACCESS_KEY>"
  },
  "parameters": {
    "region": "us-east-1",
    "service_name": "bedrock",
    "model": "amazon.titan-embed-text-v2:0",
    "dimensions": 1024,
    "normalize": true,
    "embeddingTypes": ["float"]
  },
  "actions": [
    {
      "action_type": "predict",
      "method": "POST",
      "url": "https://bedrock-runtime.${parameters.region}.amazonaws.com/model/${parameters.model}/invoke",
      "headers": {
        "content-type": "application/json",
        "x-amz-content-sha256": "required"
      },
      "request_body": "{ \"inputText\": \"${parameters.inputText}\", \"dimensions\": ${parameters.dimensions}, \"normalize\": ${parameters.normalize}, \"embeddingTypes\": ${parameters.embeddingTypes} }",
      "pre_process_function": "connector.pre_process.bedrock.embedding",
      "post_process_function": "connector.post_process.bedrock.embedding"
    }
  ]
}
POST /_plugins/_ml/models/_register?deploy=true
{
  "name": "soc-titan-embed-v2",
  "function_name": "remote",
  "description": "Titan Text Embeddings V2 for the SOC knowledge index",
  "connector_id": "<titan_connector_id>"
}
model_id из ответа на регистрацию понадобится в трех местах: в каждом запросе neural, в инструменте агента и в ingest-пайплайне. Первый вызов модели стоит сделать через predict для text-embedding: если в ответе нет массива из 1024 чисел, дальше идти незачем.
POST /_plugins/_ml/_predict/text_embedding/<titan_model_id>
{
  "text_docs": ["What does our runbook say for an SSH brute force against web-server-01?"],
  "return_number": true,
  "target_response": ["sentence_embedding"]
}
В ответе один объект sentence_embedding с массивом data из 1024 элементов, столько же, сколько указано в dimensions. Читатель первой части помнит, что там перед регистрацией коннектора записывались настройки кластера, среди них список trusted_connector_endpoints_regex, plugins.ml_commons.only_run_on_ml_node и три флага agent_framework_enabled, memory_feature_enabled и rag_pipeline_feature_enabled. На 2.19.5.0 ни одну из них писать не пришлось: в списке по умолчанию 11 шаблонов, и bedrock-runtime среди них уже есть; only_run_on_ml_node по умолчанию равен true, и с этими двумя настройками по умолчанию коннектор зарегистрировался и удаленная модель развернулась; три флага включены по умолчанию. Перед регистрацией я только прочитал настройки кластера и ничего в них не записал.

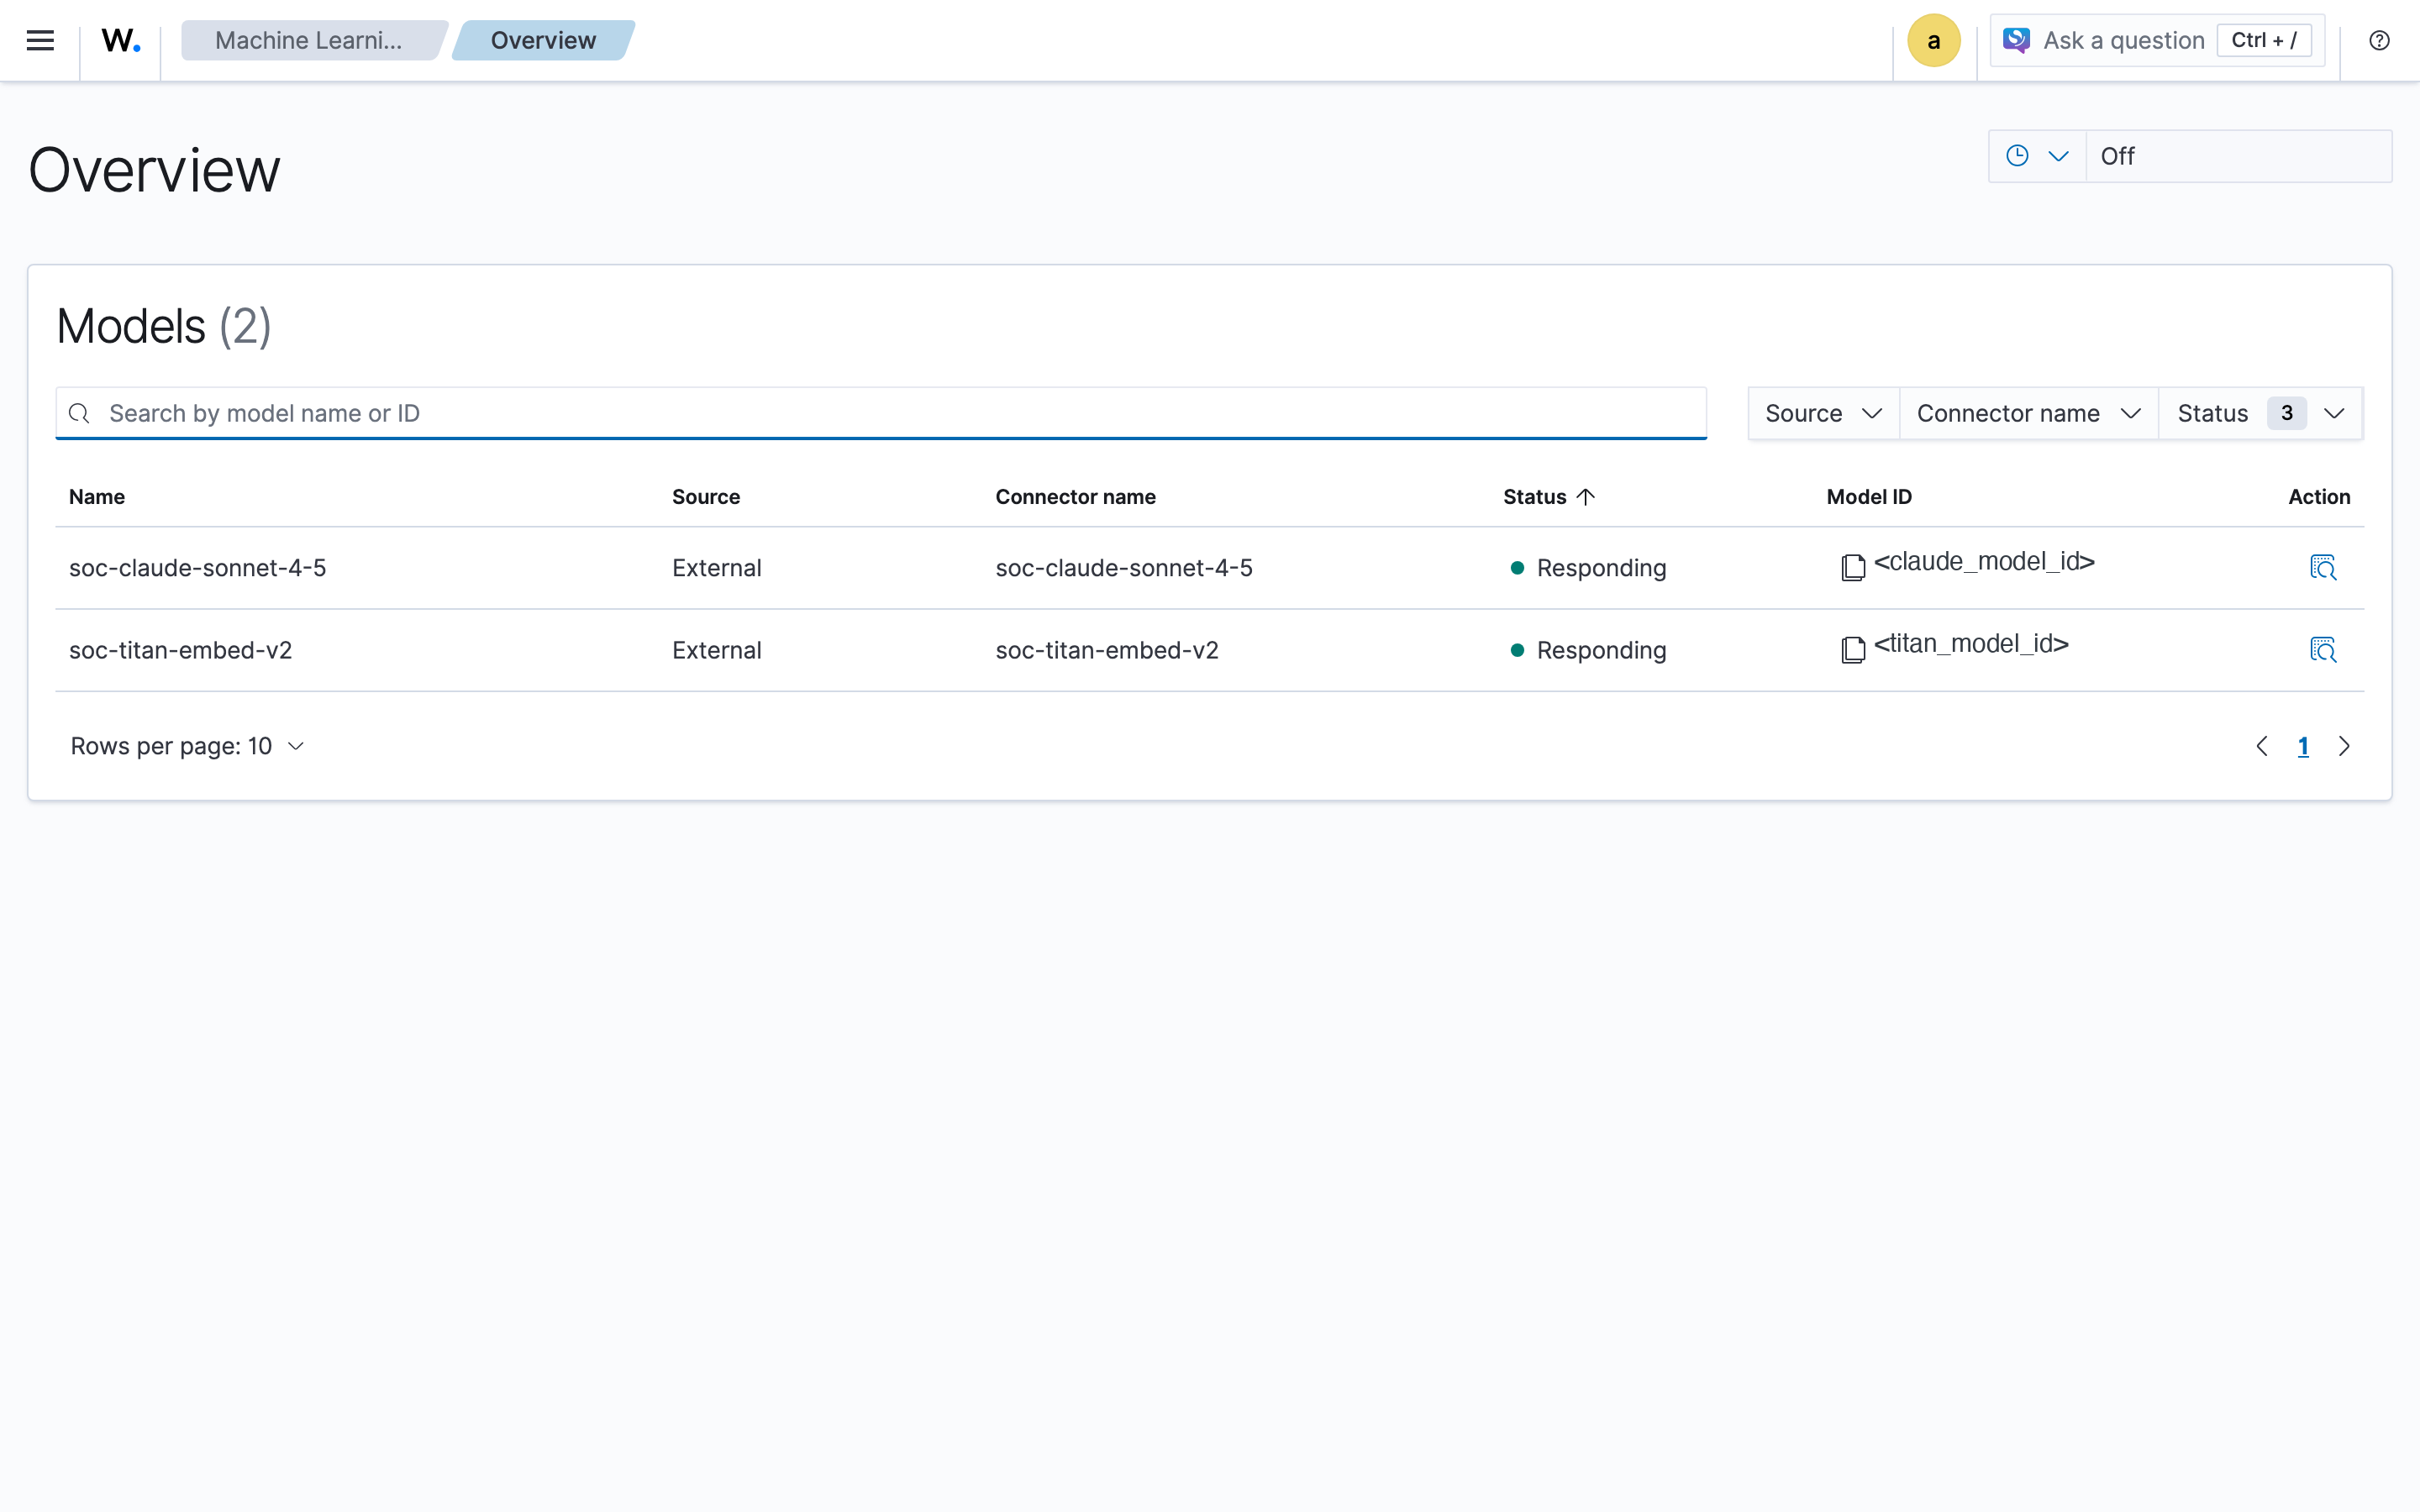
Обе удаленные модели зарегистрированы и отвечают, снимок 2026-09-02; идентификаторы моделей на снимке заменены заглушками
Где ломался векторный движок, запись и обратное чтение
Первым сломался движок. В логе контейнера Indexer после первой же записи документа в поле knn_vector с engine: faiss стояло вот что:
java.lang.UnsatisfiedLinkError: no opensearchknn_faiss in java.library.path: /usr/java/packages/lib:/usr/lib64:/lib64:/lib:/usr/lib
	at java.base/java.lang.ClassLoader.loadLibrary(ClassLoader.java:2458)
	at java.base/java.lang.Runtime.loadLibrary0(Runtime.java:916)
--
fatal error in thread [opensearch[wazuh.indexer][write][T#13]], exiting
Снаружи это выглядит так: маппинг с таким полем Indexer принимает с HTTP 200, первая запись обрывает соединение, и curl показывает HTTP 000; узел падает и стартует заново. В первый раз, 2026-09-02, при восстановлении из translog он повторил ту же запись и упал на ней снова: до удаления индекса падений набралось два. Для воспроизведения в тот же день я взял одноразовый индекс: одна запись, примерно 15 секунд до того, как узел снова ответил, удаление индекса, и счетчик перезапусков контейнера вырос с 2 до 3.
Нативных библиотек в образе wazuh/wazuh-indexer:4.14.7 нет ни для linux/amd64, ни для linux/arm64: содержимое каталога плагина я вывел 2026-09-04 из одноразовых контейнеров, по одному на платформу, с подмененной точкой входа, и в обоих там лежат opensearch-knn-2.19.5.0.jar со вспомогательными jar, а файлов libopensearchknn* нет ни одного. На этом образе проверка с lucene подтвердила то, что было важно для стенда: та же схема загрузилась без нативных библиотек. После этого во всех индексах серии я использовал lucene с ef_construction 128 вместо документированных 100 по умолчанию и с m 16, как по умолчанию. В документации нет прямого утверждения, что lucene не требует нативных библиотек. Я сделал такой вывод по странице о движках k-NN для 2.19: lucene там описан как реализация векторного поиска внутри самой библиотеки Lucene, а для Faiss перечислены библиотеки libopensearchknn_faiss*.so, которые поставляет OpenSearch. Выбора между движками в этом образе нет.

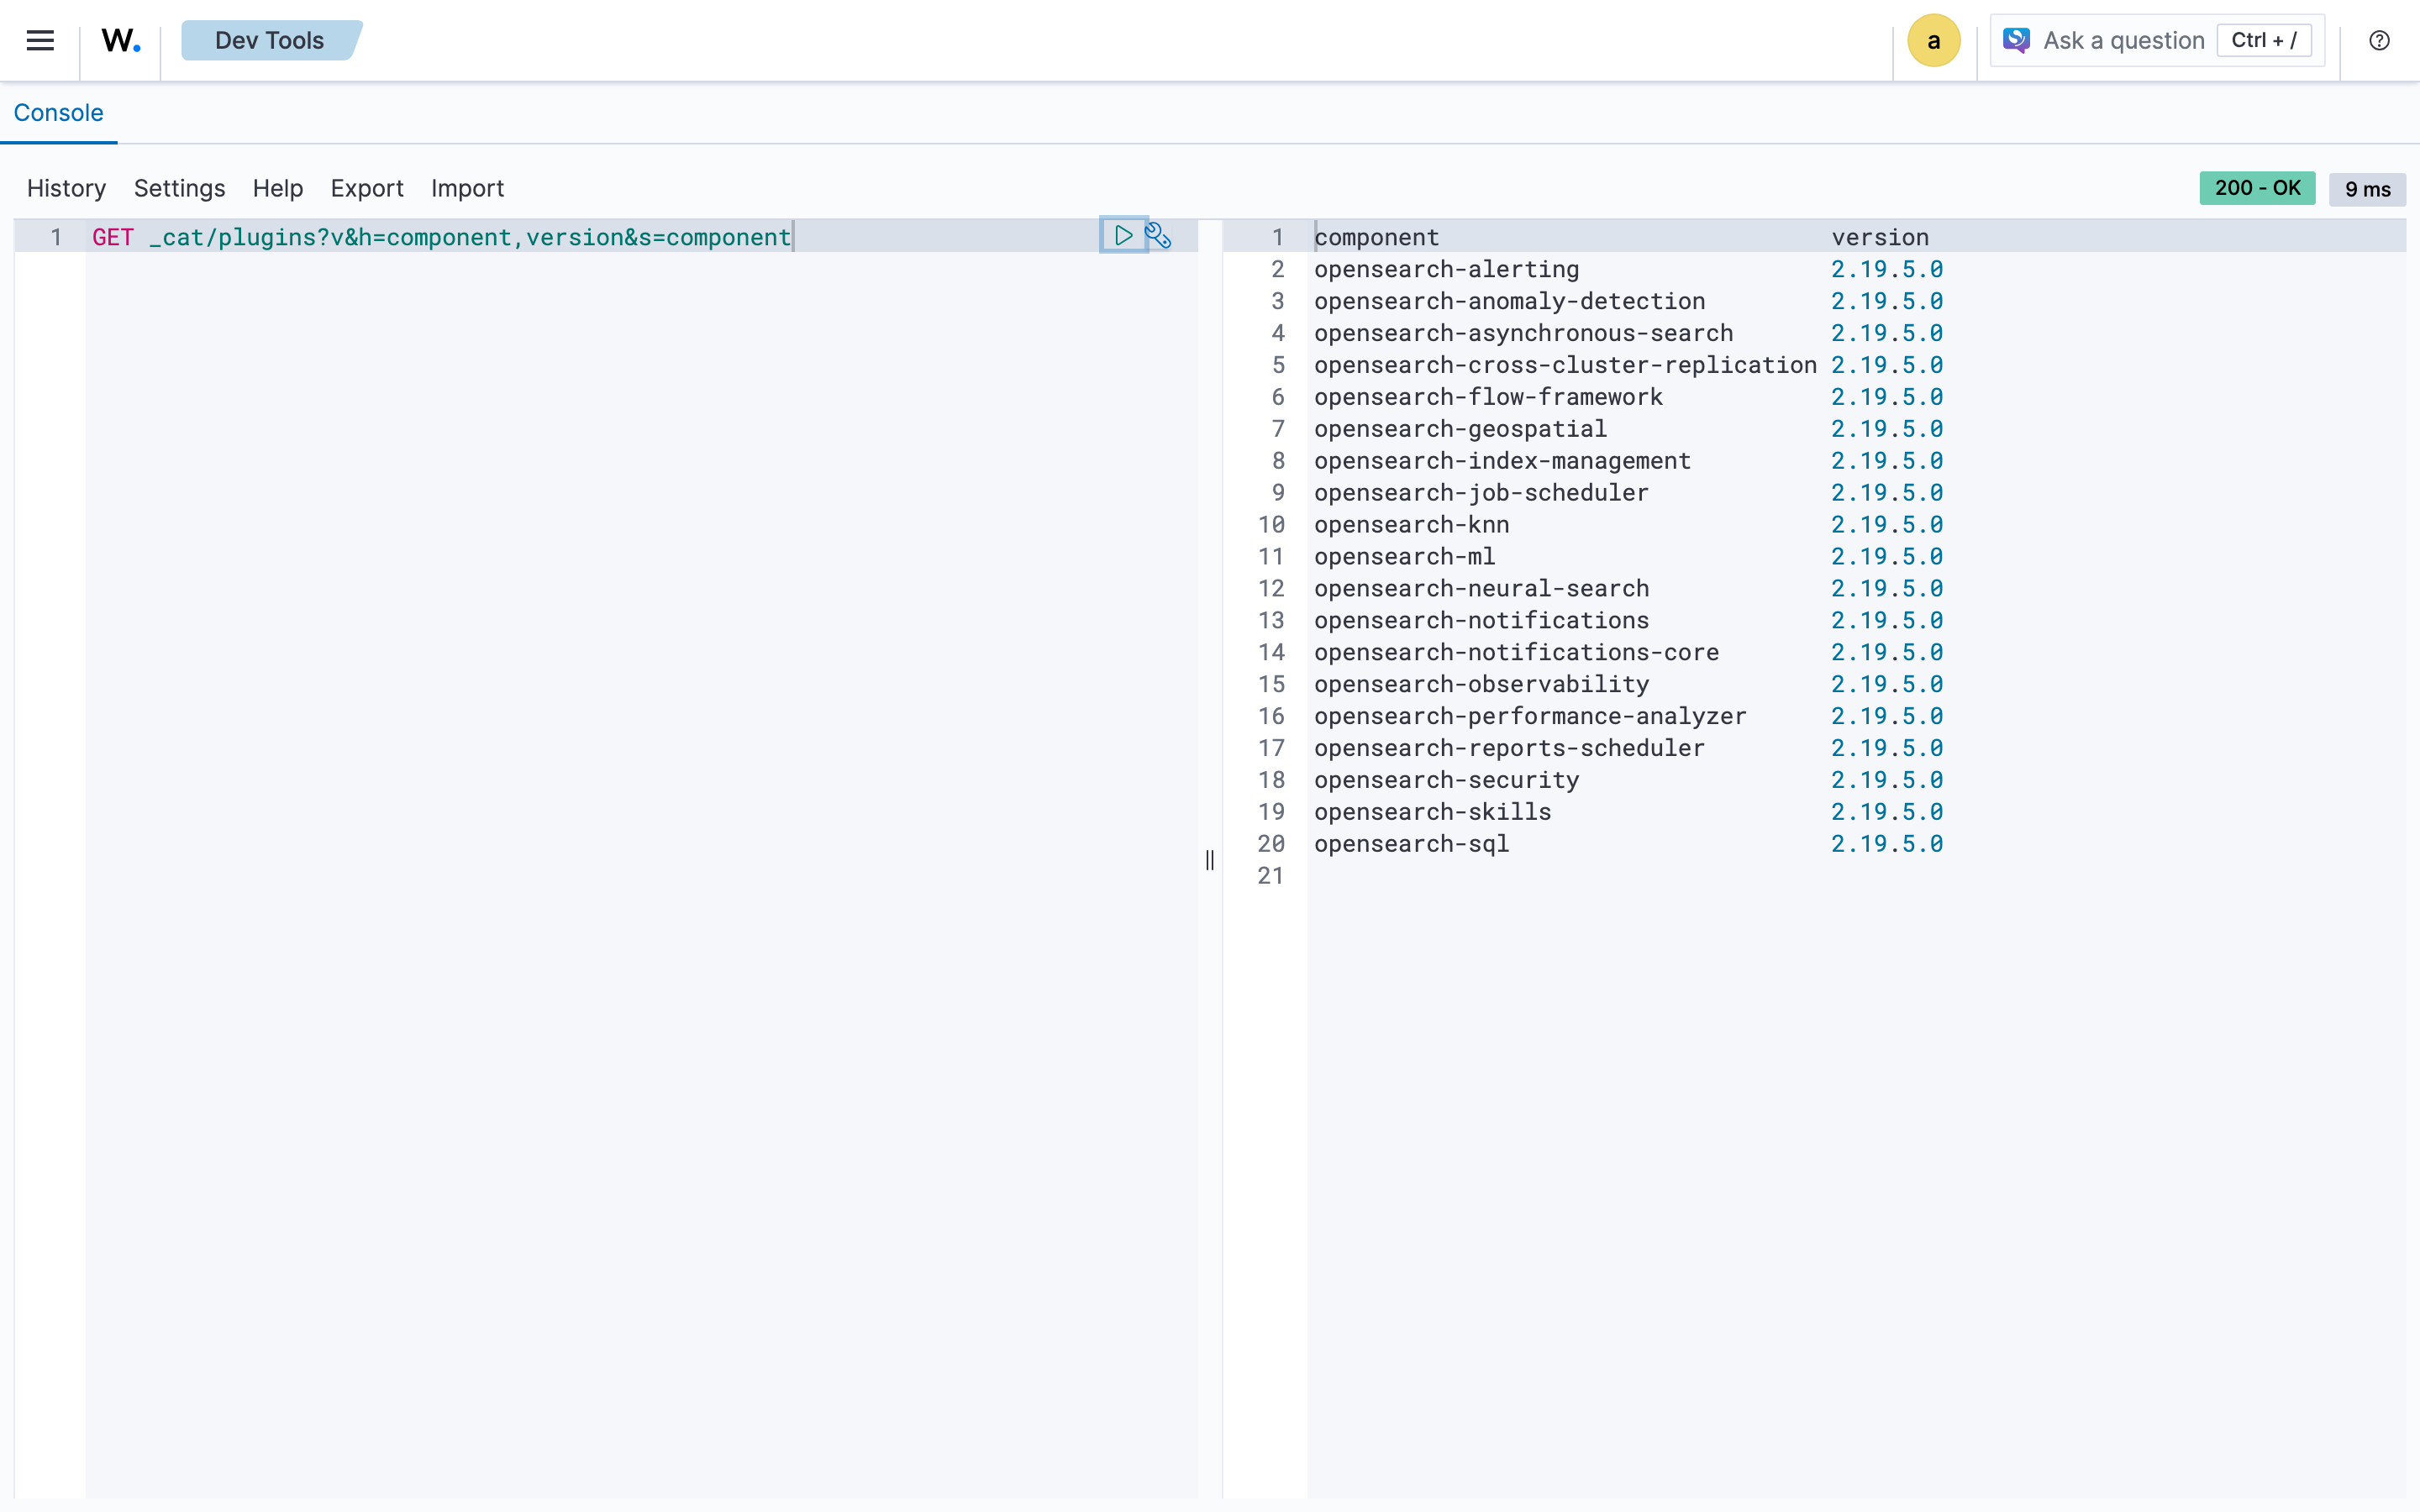
Список плагинов Indexer 2026-09-02: knn, ml и neural-search уже были в образе, skills и flow-framework поставлены командами из первой части с новыми номерами версий
Вторая поломка не роняла ничего и потому опаснее. В журнале загрузки 2026-09-03 такие строки встречаются 174 раза в первом из двух завершенных запусков и 175 во втором:
bulk: 13 items throttled (429), retry 1/6 after 2s
Каждая из них - ответ _bulk с HTTP 200 и errors: true. У части элементов в ответе _bulk стоял статус 429: Bedrock ограничивал частоту вызовов векторизации. Загрузчик в этом случае повторяет только элементы с 429 или 5xx, с паузами 2, 4, 8, 16, 32 и 64 секунды, а останавливается в трех случаях: после шести неудачных попыток, при любой другой ошибке элемента, при errors: true без указания отказавшего элемента. Все 349 повторных запросов в двух запусках завершились успешно после первой двухсекундной паузы. Если бы загрузчик смотрел только на код ответа, счетчик документов по источнику после загрузки показал бы меньше, чем отправлено, и это был бы первый признак беды. По журналам первая загрузка заняла около 15 минут, вторая около 25; паузы дают примерно шесть минут на каждую.
Третья поломка случилась один раз. Прерванный запуск 2026-09-03 остановился на _mget с ответом 400 parsing_exception: флаг _source=false стоял в теле запроса рядом с ids, а в форме параметра запроса Indexer его принимает; после исправления загрузка была выполнена заново, и сравнивались два завершившихся запуска того же дня. Этот _mget - обратное чтение, которым загрузчик перед любым удалением проверяет каждый записанный идентификатор, пачками по 500. Для оператора обратное чтение означает, что повторный запуск безопасен в любой момент: он перезаписывает те же документы, а удаляет только после обратного чтения и только для полного снимка источника, и тогда из индекса уходят те документы этого источника, которых запуск не прислал. Поле version при этом остается способом отобрать поколение документов запросом term.
Как агенту дали дочитать плейбук
SocPlaybookRead и есть ответ на пропущенную блокировку из введения: после его вызова модель видит уже не один фрагмент, а весь плейбук, все шесть фрагментов по порядку номеров chunk, отобранные по source, doc_id и version найденного попадания. Это SearchIndexTool; doc_id и version модель берет из ответа поискового инструмента SocKnowledgeSearch (VectorDBTool), который отдает их вместе с текстом каждого попадания. Четыре инструмента для алертов из первой части остались как были.
Описание инструмента чтения содержит литерал, в котором модель меняет только DOC_ID и VERSION, и две его детали появились после ошибок на реальных вызовах. Одна ошибка касалась формы фильтра. По документации значение query - целое тело поискового запроса, а модель положила bool прямо под верхний query, и OpenSearch получил вместо тела один фильтр: Unknown key for a START_OBJECT in [bool]. Поэтому в литерале фильтр завернут во второй, вложенный query. Другая касалась сортировки по chunk: без track_scores вызов оборвался на сообщении Gson NaN is not a valid double value as per JSON specification, а с track_scores: true в литерале проходит; что именно внутри инструмента спотыкается о непосчитанную оценку, по одному сообщению утверждать нельзя. У поискового инструмента правило одно, и оно тоже родилось из ошибки: когда агент передал ему объект Query DSL вместо вопроса, Bedrock ответил HTTP 400 Invalid payload, и в ошибке был виден тот же JSON внутри inputText. Практический вывод для загрузчика: все, что коннектор подставляет в inputText, должно оставаться обычным текстом, потому что валидный JSON он вставляет как есть, без экранирования, и такой фрагмент сломал бы тело запроса на первой же записи. Поэтому каждый фрагмент начинается с заголовка секции, а тому, что и с заголовком разбирается как JSON, загрузчик ставит префикс Excerpt:; описание поискового инструмента после этой ошибки требует от модели одной строки обычного текста.
[
  {
    "type": "VectorDBTool",
    "name": "SocKnowledgeSearch",
    "description": "Semantic search over the SOC knowledge base: MITRE ATT&CK techniques and mitigations, Wazuh 4.14 documentation, the team's playbooks for an SSH brute force against web-server-01, an unexpected change to sshd_config, a web server process that spawned a shell and alerts at level 12 or higher, and recent MISP threat intelligence events. INPUT RULE: the input is the question or topic as one plain-text sentence, for example: SSH brute force playbook for web-server-01. NEVER pass JSON, a Query DSL object, an index name or field names as the input: this tool embeds the input text as it is, and a JSON input is refused by the embedding model. Every hit carries source, doc_id, chunk, title, text, url and version. A playbook hit is one section of a document; pass its doc_id and version to SocPlaybookRead to read the whole document.",
    "parameters": {
      "model_id": "<titan_model_id>",
      "index": "soc-knowledge",
      "embedding_field": "text_embedding",
      "source_field": [
        "source",
        "doc_id",
        "chunk",
        "title",
        "text",
        "url",
        "version"
      ],
      "doc_size": 5,
      "k": 10,
      "input": "${parameters.question}"
    }
  },
  {
    "type": "SearchIndexTool",
    "name": "SocPlaybookRead",
    "description": "Reads one playbook document of the SOC knowledge base through, in section order. INPUT RULE: the input is one JSON object with exactly two top-level keys, index and query. index is always the string soc-knowledge. The value of query is the COMPLETE search request body, and that body has its own key named query holding the bool filter, beside sort, size and _source. Never put bool directly under the top-level query, and never put sort, size or _source at the top level. Copy this literal input and replace only DOC_ID and VERSION with the doc_id and version of the SocKnowledgeSearch hit: {\"index\": \"soc-knowledge\", \"query\": {\"query\": {\"bool\": {\"filter\": [{\"term\": {\"source\": \"playbook\"}}, {\"term\": {\"doc_id\": \"DOC_ID\"}}, {\"term\": {\"version\": \"VERSION\"}}]}}, \"sort\": [{\"chunk\": \"asc\"}], \"track_scores\": true, \"size\": 20, \"_source\": [\"source\", \"doc_id\", \"chunk\", \"title\", \"text\", \"version\"]}}. track_scores must be true: this tool serialises the score of every hit, and a sort without computed scores makes it fail. Use the doc_id and version of the hit, never a guessed name. Every returned hit is one section of that one document; read them all before answering.",
    "parameters": {
      "index": "soc-knowledge"
    }
  }
]
Ответ агент собирает из пяти помеченных частей, и на русский вопрос метки русские: Правила, Владелец, Действия по сдерживанию, Условия эскалации, Источники (в английском ответе Rules covered, Owner, Containment actions, Escalation conditions, Sources quoted). Под меткой владельца стоит короткая фраза со значением из поля Owner документа; если владельца в контексте нет, инструкция велит писать Owner: not found, и этот литерал в ней один на оба языка. Эти требования лежат в llm.parameters под ключом prompt.prefix, и этот ключ продиктован коннектором. Тело запроса коннектора Claude из первой части отправляет модели ровно один параметр:
"content": [{"type": "text", "text": "${parameters.prompt}"}]
Текст для модели это тело берет только из prompt, других текстовых полей в шаблоне нет; поэтому у ключа system_instruction, под которым инструкция лежала в прежнем определении агента, не было шанса: в шаблоне его значение никуда не подставляется. Пять помеченных частей в ответах появились, когда инструкция переехала в prompt.prefix. Сам prompt чат-агент ML Commons 2.19 склеивает из трех кусков, prompt, prompt.prefix и prompt.suffix (MLChatAgentRunner и AgentUtils.addPrefixSuffixToPrompt); префикс и есть то место, куда инструкция ложится, на английский и на русский вопрос одинаково.
Проверка ответа устроена так. Для каждого языка выполняется один вызов _execute с verbose: true, и в трассировке я ищу четыре признака отказа, у каждого свой след:
- поиск пропущен: тогда шаг чтения стоял бы в трассировке первым или единственным; в обоих запусках он идет после шага поиска;
- прочитан не тот документ: тогда в запросе чтения стояли бы
doc_idиversion, которых нет в ответе поиска; в запросе тот же индекс и те же значения, что вернул поиск; - прочитан не целиком: тогда в ответе чтения не хватало бы фрагментов или их заголовков; в нем ровно шесть, с 0 по 5, с теми же заголовками разделов, что в файле при загрузке;
- утверждение выдумано: тогда в ответе нашлось бы утверждение без фрагмента в выдаче инструментов; у каждого утверждения такой фрагмент есть.
Ответы на обоих языках прошли эту проверку 2026-09-04, и только после этого агент был привязан к чату Dashboard. В первой части тот же документ os_chat в .plugins-ml-config записывался под администраторским сертификатом Indexer; сертификат тот же и здесь, а к записи добавилось условие. Перед ней документ читается, и запрос обновления несет прочитанные _seq_no и _primary_term. Если после чтения документ изменился, Indexer отвечает HTTP 409 на условный запрос обновления и ничего не перезаписывает. Актуальную привязку после отказа показывает отдельное чтение; при совпадении версий обновление проходит, и результат читается обратно. Русский ответ из журнала, без части о правилах:
[...]

**Владелец:** SOC tier 1

**Действия по сдерживанию:** Заблокировать адрес источника на хостовом брандмауэре web-server-01 с помощью активного ответа firewall-drop на 12 часов. Подтвердить действие в /var/ossec/logs/active-responses.log и проверить состояние брандмауэра на конечной точке. Нулевое количество последующих алертов является только подтверждающим свидетельством, потому что источник мог прекратить отправку трафика. Не отключать службу sshd.

**Условия эскалации:** Эскалация на tier 2 происходит, если выполняется любое из следующих условий: успешный вход с заблокированного адреса до блокировки, более трех хостов атакованных одним и тем же адресом, или учетная запись пользователя, которая не входит в ожидаемый список администраторов. Также эскалация необходима, когда сдерживание не удается или когда за всплеском следует успешный вход.

**Источники:** ssh-brute-force-web-server-01.md версии playbook-2026-09, разделы: Playbook: SSH brute force against web-server-01, Detection, Triage, Containment, Escalation.

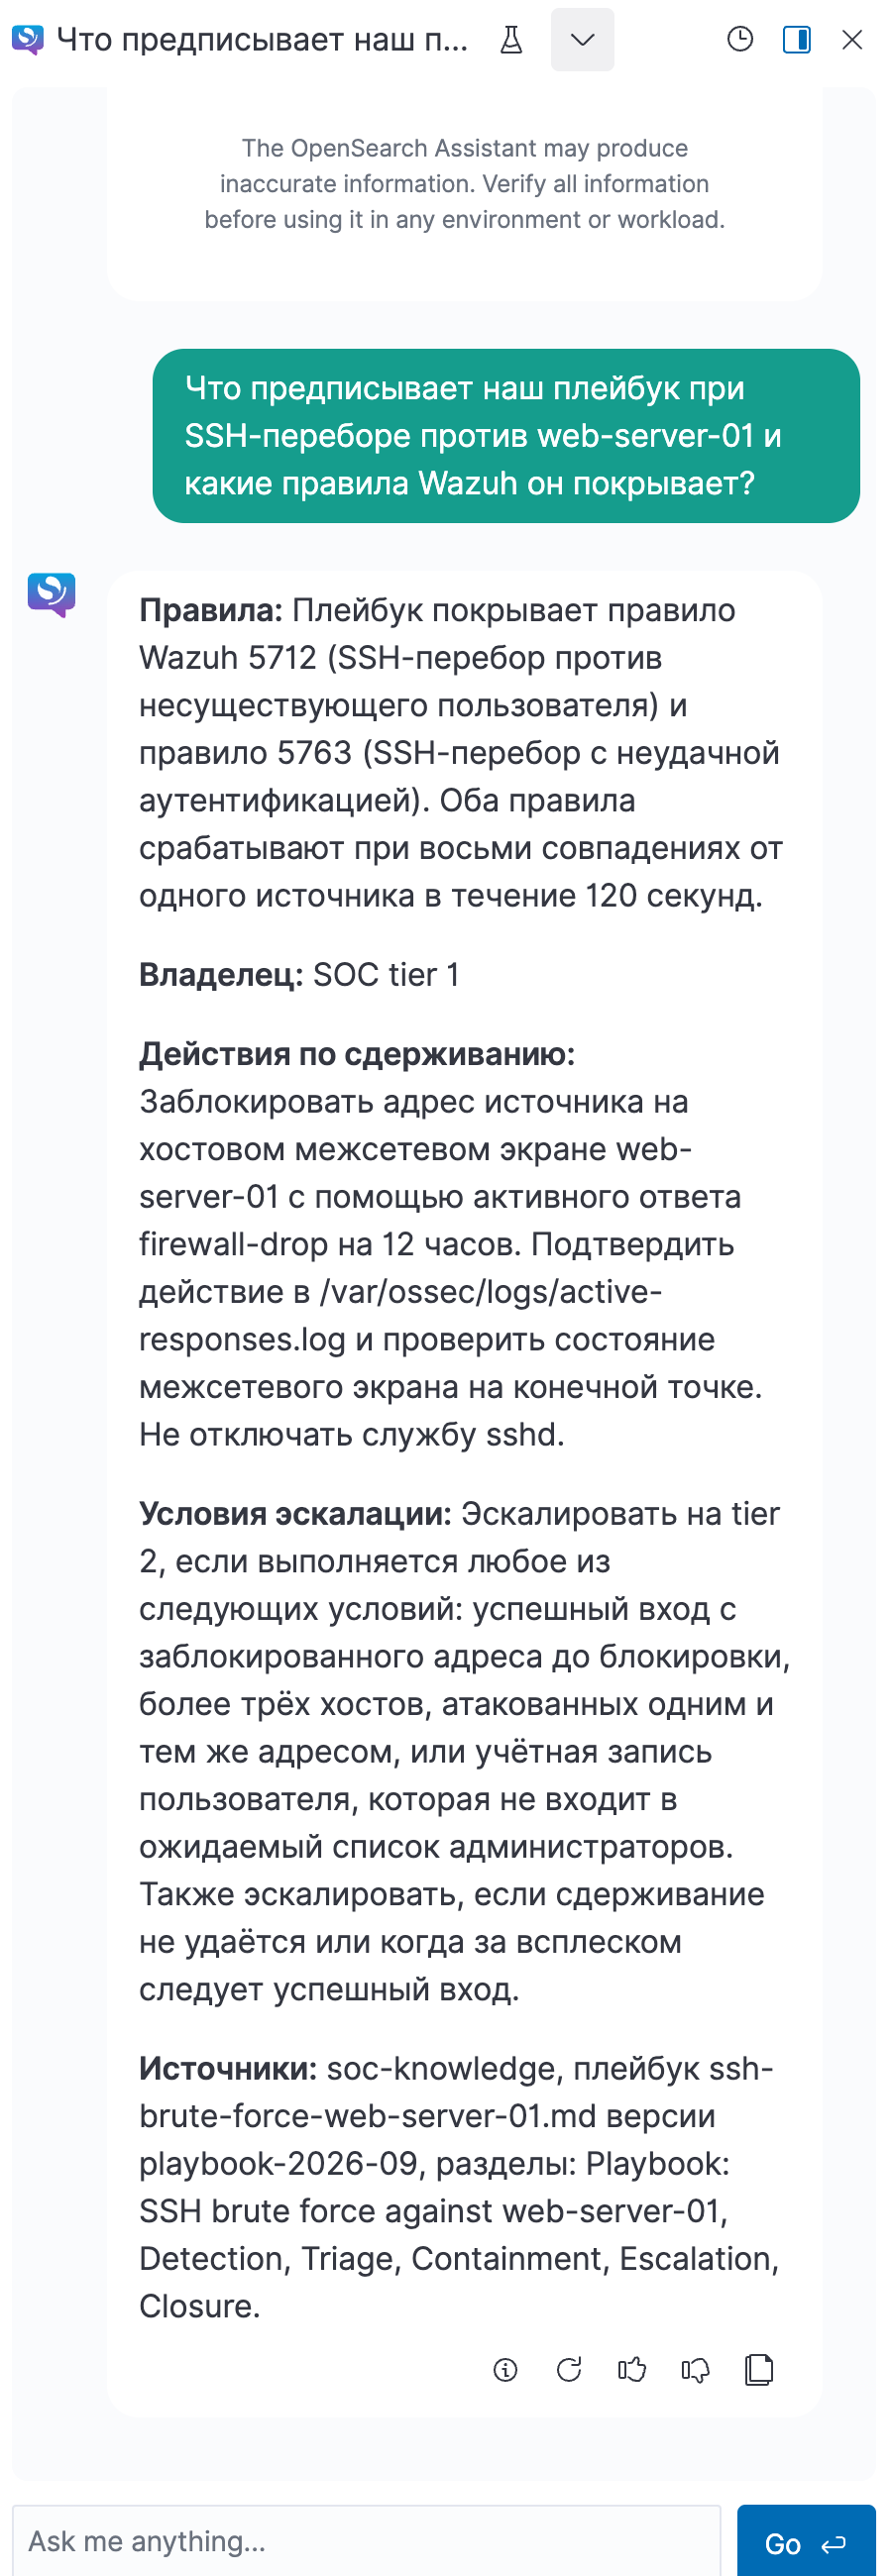
Чат Dashboard с агентом чтения плейбука, тот же вопрос задан 2026-09-04; это свежий ответ привязанного агента, а не ответ из журнала выше
Запросы к индексу и отрицательные контроли
Для интеграции, которая не хочет заводить агента, индекс доступен обычными запросами, и здесь пригодится поле source из маппинга: neural с фильтром по нему опрашивает один корпус.
POST /soc-knowledge/_search
{
  "size": 5,
  "_source": ["source", "title", "doc_id", "url"],
  "query": {
    "neural": {
      "text_embedding": {
        "query_text": "Which technique covers password guessing against SSH and what mitigates it?",
        "model_id": "<titan_model_id>",
        "k": 5,
        "filter": { "term": { "source": "mitre" } }
      }
    }
  }
}
Таблица ниже отвечает на вопрос, узнает ли каждый корпус свою тему: четыре запроса 2026-09-04, по одному на корпус, с тем же телом и своим вопросом.
| Фильтр | Вопрос | Первое попадание | Оценка |
|---|---|---|---|
mitre | Which technique covers password guessing against SSH and what mitigates it? | T1110.001 Password Guessing, следом мера противодействия T1184 SSH Hijacking с 0.7979 | 0.8128 |
wazuh-docs | What is the manager configuration block for vulnerability detection called? | configuring-scans.rst, раздел Configuration | 0.7858 |
playbook | How long do we block a brute force source on web-server-01? | раздел Containment плейбука SSH-перебора, за ним строка Scope того же плейбука (фрагмент 0) с 0.7298 и Detection с 0.6776 | 0.7598 |
misp | Recent Emotet infrastructure | пять ежедневных дайджестов Maltrail IOC с оценками от 0.5998 до 0.5874 | 0.5998 |
Строка MISP выпадает из таблицы: судя по заголовкам дайджестов, связной прозы в этом источнике почти нет, и поиск вернул пять дайджестов с оценками, которые расходятся лишь во втором знаке, без явного лидера. У трех остальных строк явный лидер есть, и это нужный документ; у документации и плейбука это к тому же нужный раздел.

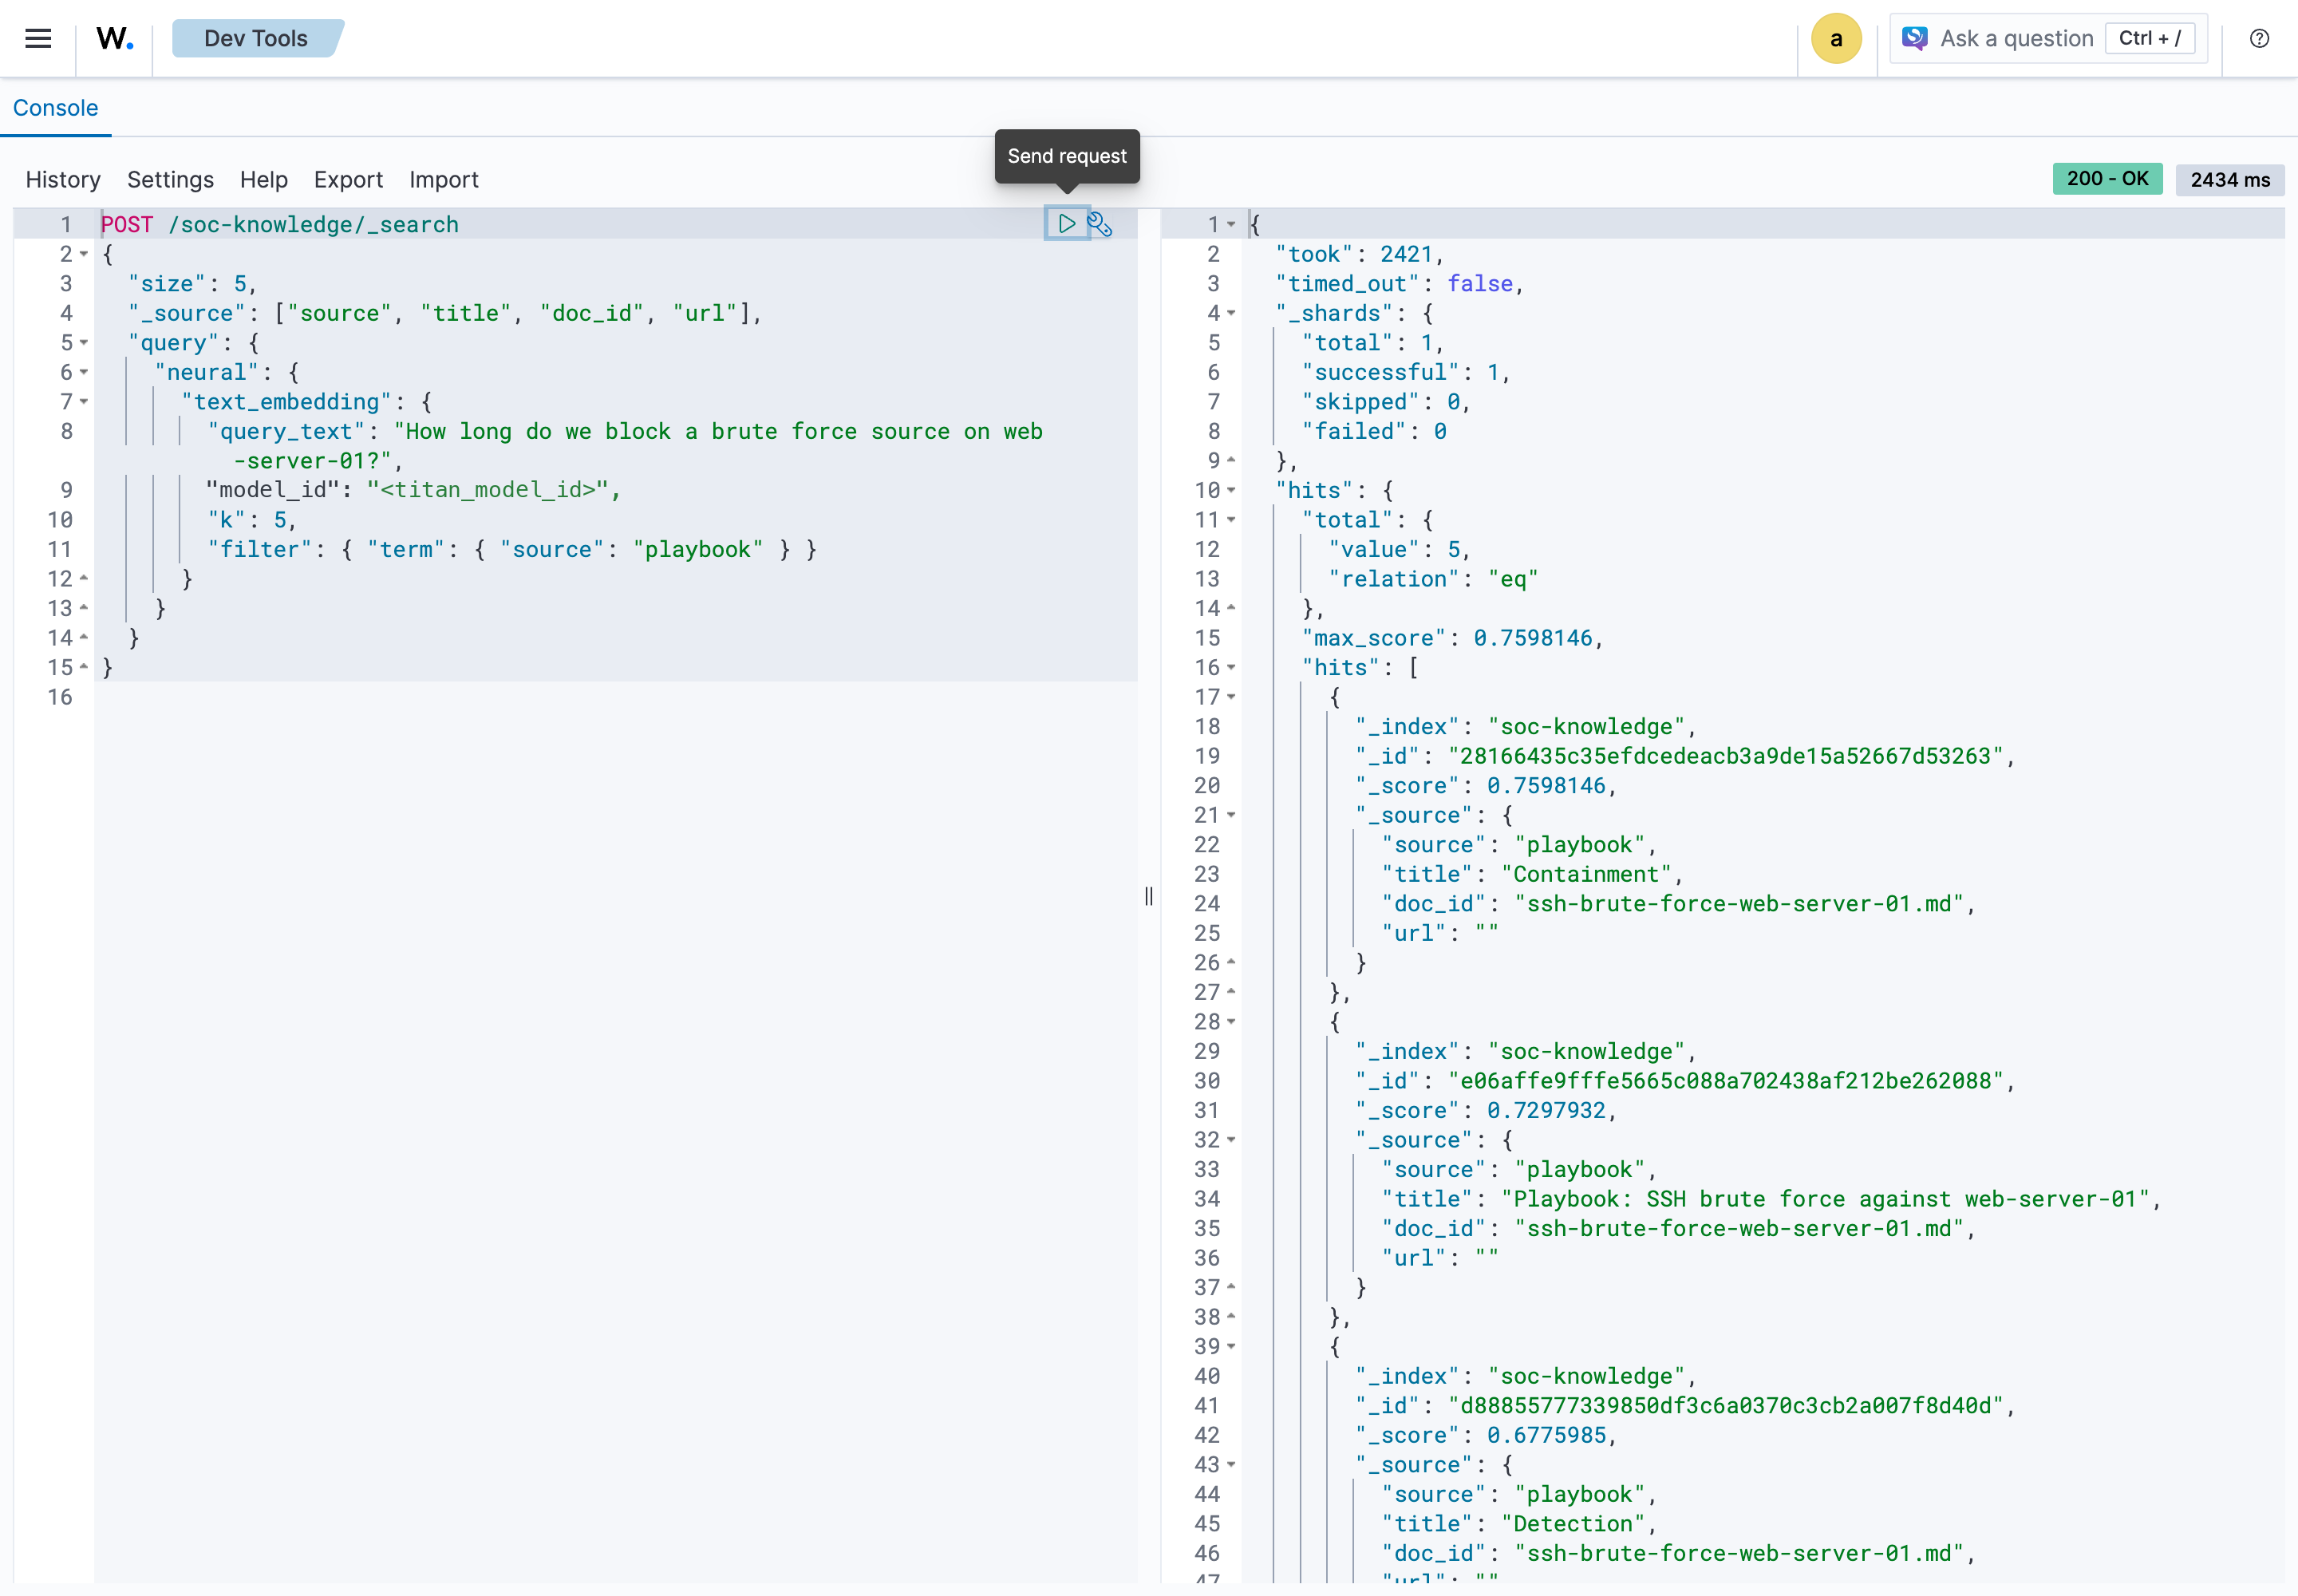
Отдельное выполнение запроса neural по одним плейбукам в Dev Tools, 2026-09-04; идентификатор модели в запросе заменен заглушкой
Для индикатора к векторной части добавляется точный запрос term по полю indicators. Как оценки двух частей складываются, видно из арифметики пайплайна на примере одного sha256, взятого из загруженных событий MISP в день запуска:
единственное попадание term:   1.0 x 0.7 + 0   x 0.3 = 0.7
лучший сосед по вектору:       0   x 0.7 + 1.0 x 0.3 = 0.3
POST /soc-knowledge/_search
{
  "size": 5,
  "_source": ["source", "title", "doc_id", "indicators"],
  "query": {
    "hybrid": {
      "queries": [
        { "term": { "indicators": "0d2211b7e92fcc6a9f7c94d4adf8e47f6f97e31dacd3b2ffb6cce3c485fcef26" } },
        {
          "neural": {
            "text_embedding": {
              "query_text": "Is this file hash known malware and which campaign does it belong to?",
              "model_id": "<titan_model_id>",
              "k": 10
            }
          }
        }
      ]
    }
  }
}
Ровно эти 0.7 и 0.3 и пришли 2026-09-04: первым из 11 попаданий за 574 мс событие MISP с этим хешем, Malicious File Creates Network Socket and Contacts fdh32fsdfhs.shop, вторым раздел руководства об обнаружении вредоносных файлов по хешам через CDB-список. Вес 0.7 у точной части нужен ради этого порядка. Чего стоит один вектор без term, я проверял в оба дня, каждый раз с хешем из событий того дня, и в обоих случаях без точной части нужное событие либо не попадает в первую пятерку, либо уступает первое место.
| День | Хеш | Только вектор | Гибридный запрос |
|---|---|---|---|
| 2026-09-04 | из события о fdh32fsdfhs.shop | пять дайджестов Maltrail IOC от 0.6772 до 0.6610, самого события нет | событие первое, 0.7000 |
| 2026-09-02, предыдущая сборка индекса | из события CERT-FR о Sandworm | событие третье, 0.6645 | событие первое, 0.7000 |
Запрос без term 2026-09-04 отличался от гибридного только тем, что хеш был дописан в текст вопроса, а у векторной части стояли фильтр source: misp и k 5.

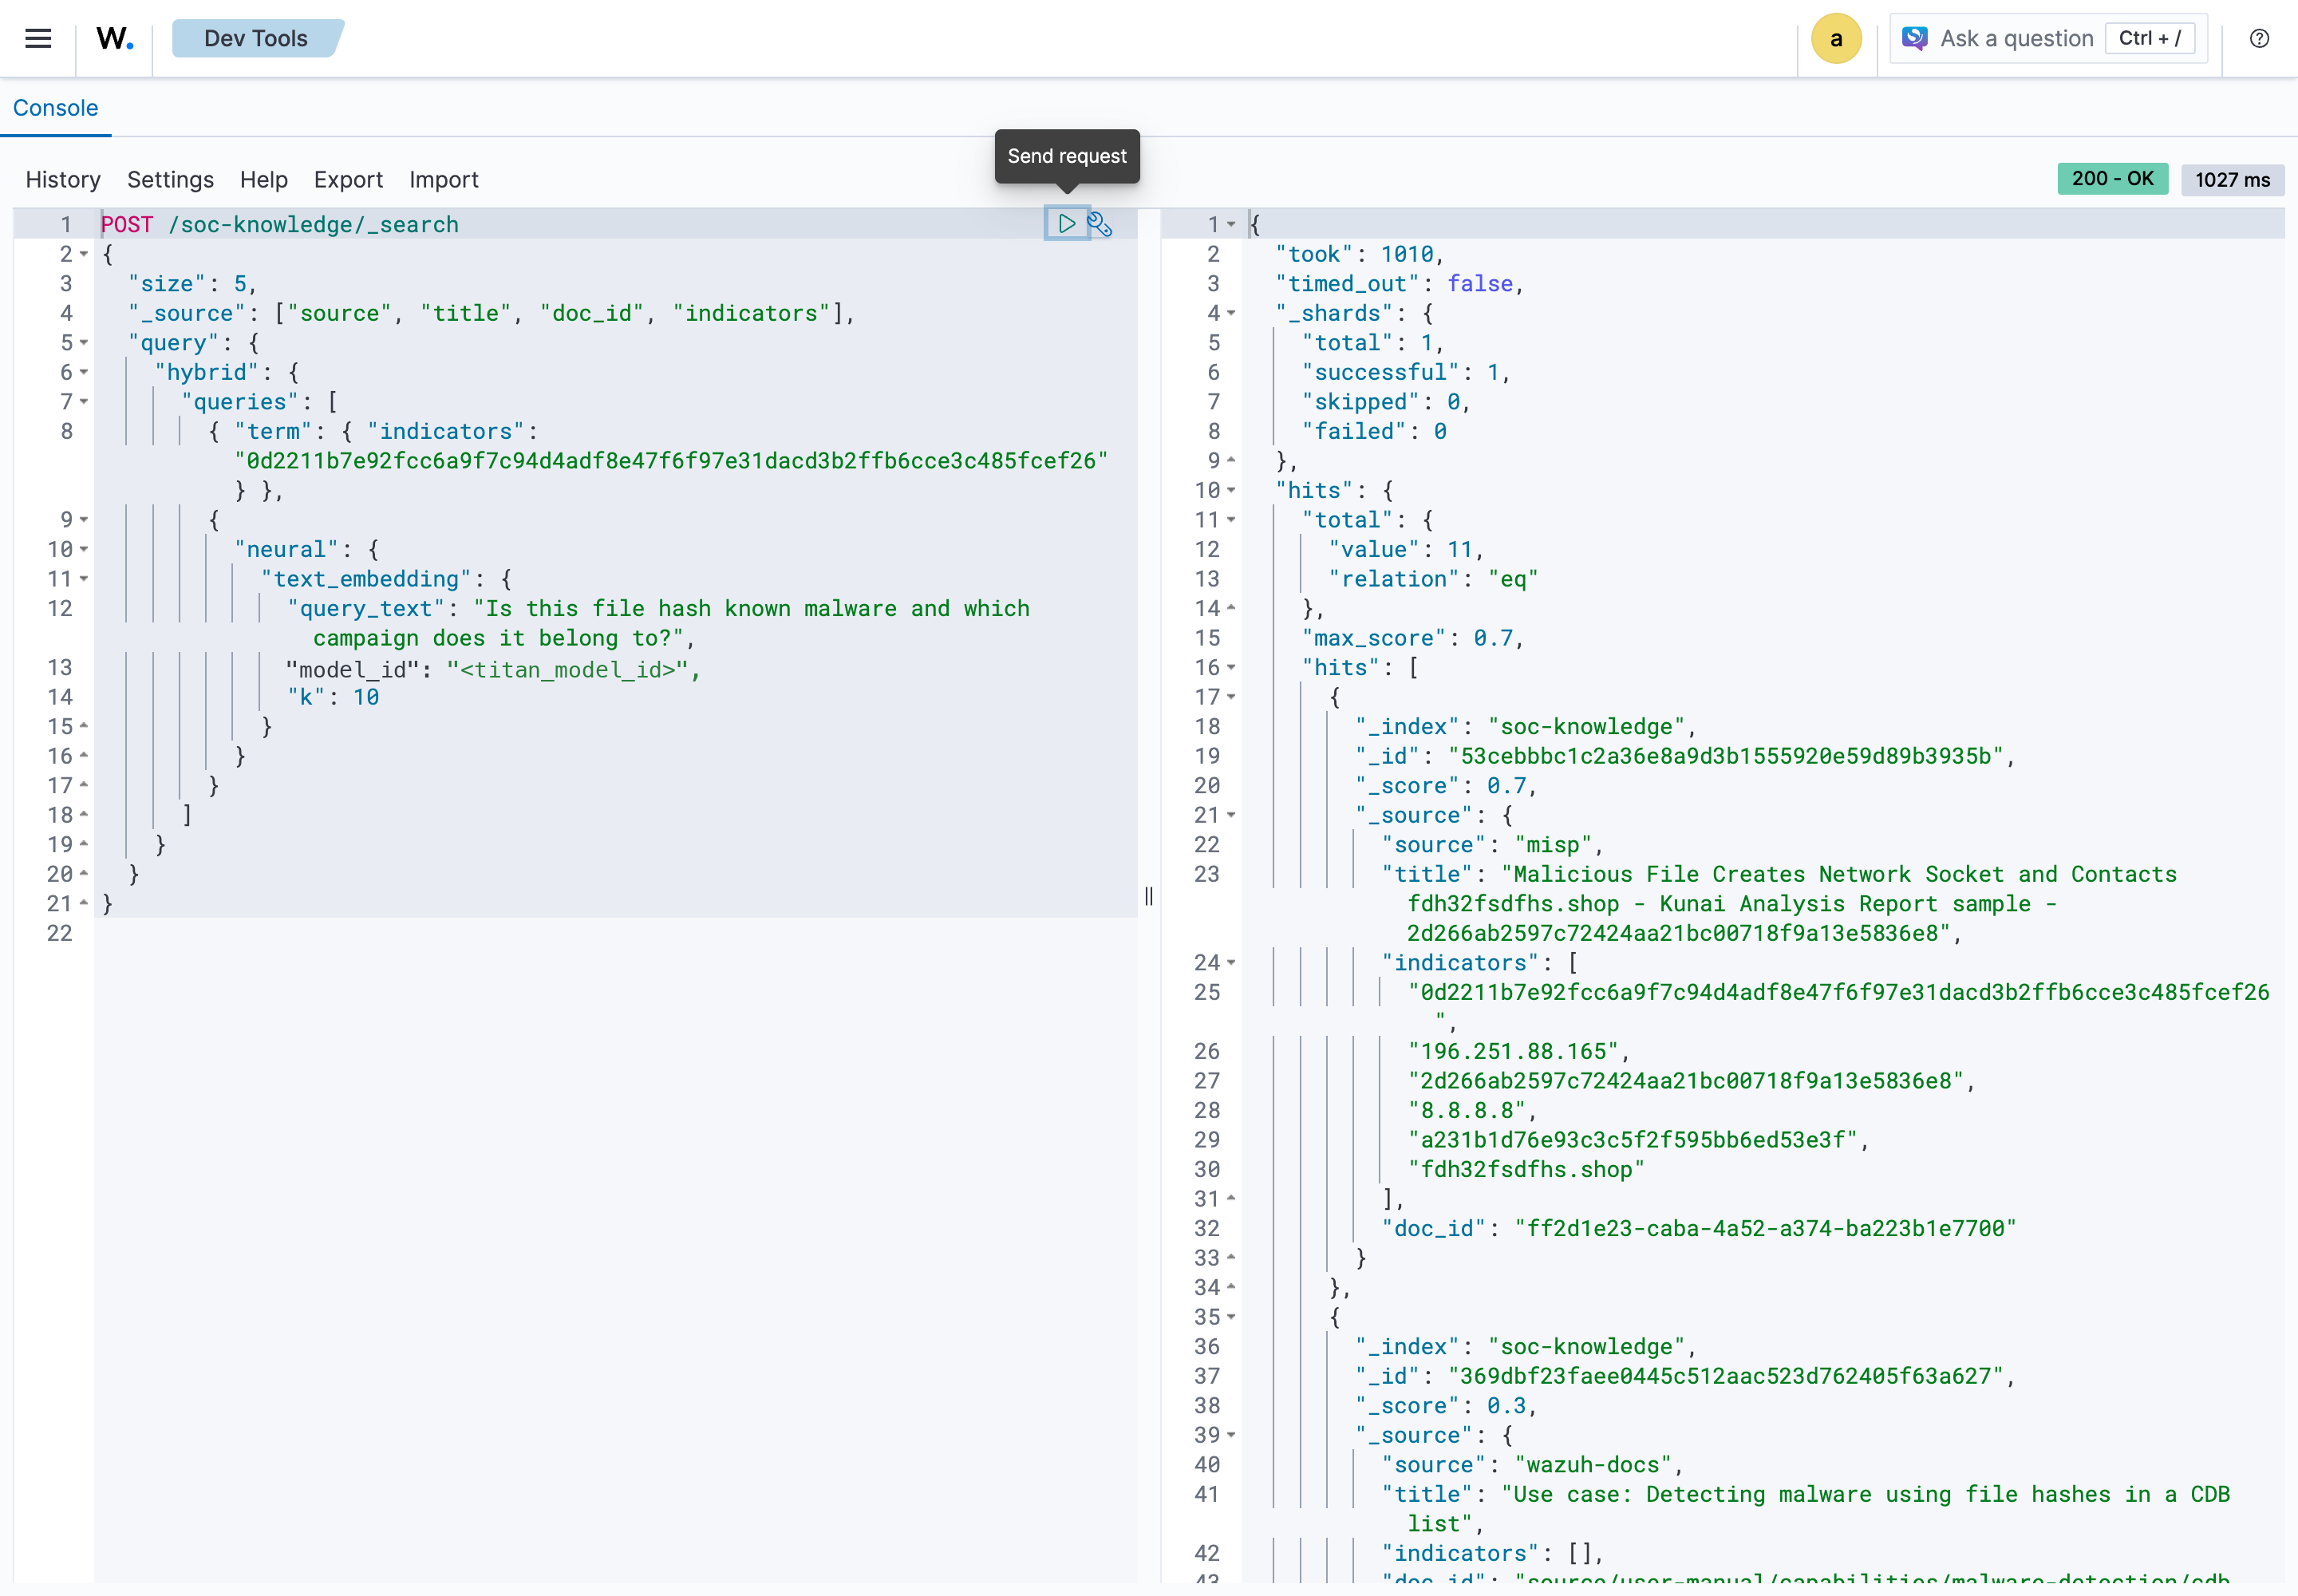
Отдельное выполнение гибридного запроса в Dev Tools, 2026-09-04: событие с точным хешем на первом месте; идентификатор модели в запросе заменен заглушкой
Читателю второй части важнее другое: что меняется для Claude Desktop. Ничего. Сайдкар из второй части пересылает тело запроса как есть, за вектором в Bedrock ходит сам Indexer, веса берутся из пайплайна индекса по умолчанию. Единственное, что надо знать, - имя аргумента, в который SearchIndexTool сайдкара (с инструментом агента у него общее только имя) принимает тело. На этой сборке схема инструмента состоит из format, index, query_dsl и size, но надежнее прочитать имя в ответе tools/list своей сборки, чем взять из этой статьи.
{ "jsonrpc": "2.0", "id": 1, "method": "tools/call",
  "params": { "name": "SearchIndexTool",
              "arguments": { "index": "soc-knowledge", "query_dsl": { ...гибридный запрос выше... } } } }
По сравнению с прямым гибридным запросом выше разницы почти нет: сайдкар 2026-09-04 ответил isError: false, в ответе то же событие первым с оценкой 0.7 и хешем в массиве indicators, те же 11 попаданий, за 503 мс против 574.
Почти правильный ответ из введения появился на верных документах. Что делает поиск, когда верных документов нет или они устарели, показывают два контроля; оба работают в одноразовых индексах с тем же маппингом и пайплайном, в soc-knowledge они ничего не пишут, и там до и после них по 7118 документов.
Устаревшие страницы. Вопрос один: как называется XML-блок менеджера для vulnerability detection. Индексов два, soc-knowledge-stale и soc-knowledge-fresh, и разница между ними только в возрасте одних и тех же трех страниц руководства: ветка 4.7 на коммите 288e2ee против ветки 4.14 на коммите e3296dd. От каждого контрольного ответа ниже сохраняются первые 300 символов, отсюда обрыв на полуслове в последнем из них. Ответ модели по устаревшему индексу (10 фрагментов; из пяти найденных старое имя есть в первом и в пятом):
Based on the documentation excerpt, the XML block for vulnerability detection is called: **vulnerability-detector**
Ответ по свежему индексу (13 фрагментов; текущее имя есть во втором и в пятом из пяти):
Based on the documentation, the XML block for vulnerability detection is called: **vulnerability-detection** This is shown in the exact tag format: `<vulnerability-detection>`
На верных документах модель назвала верное имя, на устаревших - старое, и оба ответа одинаково уверены: по ответу нельзя определить, насколько свежи данные. Порог по оценке тоже не поможет. В свежем индексе фрагменты с нужным именем стоят на 0.7931 и 0.7414, а фрагменты без него - на 0.7946, 0.7591 и 0.7528. В устаревшем индексе старое имя стоит на 0.7852 и 0.7454, а фрагменты без него - на 0.7739, 0.7596 и 0.7539. Любой порог, который пропускает нужные фрагменты, пропускает и фрагменты без нужного имени.
Молчаливый промах. k-NN отдает k ближайших векторов независимо от того, есть ли среди них нужный, и этот контроль показывает, как такой промах выглядит. Индекс soc-knowledge-miss собран из каталогов vulnerability detection и ossec-conf версии 4.14 на том же коммите, в них 48 страниц; 4 файла, совпадающие с vulnerability-detect(or|ion), исключены, остальные дали 1099 фрагментов. Что ни одно из двух имен блока, старое и текущее, в индекс не попало, пришлось подтверждать проходом по сырому тексту всех 1099 фрагментов, и он не нашел ни одного вхождения; запросу query_string по имени блока верить было нельзя, потому что 12 его попаданий состояли из прозы, где оба слова имени стоят рядом без дефиса, а стандартный анализатор дефис из имени убирает. Ранжированный список по такому индексу ничем не отличается от списка по индексу с ответом: пять фрагментов с оценками от 0.7946 до 0.7547. Модель на этих пяти фрагментах ответила отказом:
Based on the documentation provided, the XML tag name for vulnerability detection is not explicitly shown in these excerpts. The documentation discusses the Vulnerability Detection module and its functionality, but does not include a section showing the XML configuration block name for vulnerability
Два вопроса после контролей остаются без ответа, и о них стоит помнить, читая любой ответ агента. Какой из пяти фрагментов модель прочла? По журналу не видно: в нем ранжированный список и текст ответа, а не путь модели по ним. Откажется ли она отвечать и завтра? Отказ зафиксирован для одного дня и одного промпта; чтобы называть его свойством схемы, понадобилось бы повторить контроль в другие дни и с другими формулировками, а до тех пор на тех же пяти фрагментах возможен и уверенный ответ с неверным именем.
Что получилось на этой установке и чего результат не обещает
По прайс-листу полная загрузка стоит от $0.021 до $0.044, а прямой запрос к индексу - один вектор; в сценарии с агентом каждый поисковый вызов добавляет один вектор к вызовам Claude. Тариф взят из AWS Pricing API 2026-09-04: Titan Text Embeddings V2 в us-east-1 по on-demand стоит $0.00002 за 1000 входных токенов, тип использования USE1-TitanEmbeddingV2-Text-input-tokens, дата вступления в силу 2026-08-01. Объем текста посчитан проходом по индексу через Scroll API в тот же день: 10885546 символов в 7118 документах индекса, из них 6271908 от MISP, 2929684 от документации, 1678191 от MITRE и 5763 от плейбуков. Соотношения символов к токенам взяты с одной страницы руководства; для MITRE, плейбуков и MISP они не измерялись, и оценка в токенах держится на допущении, что там они те же: 10885546 / 10,48 = 1,04 млн и 10885546 / 4,99 = 2,18 млн, и отсюда 1,04 млн x 0.00002 / 1000 = $0.021 и 2,18 млн x 0.00002 / 1000 = $0.044. Для корпуса такого размера пакетный режим Titan заводить незачем, хотя он есть: Titan V2 поддерживает Bedrock Batch, AWS назначает пакетной обработке для поддерживаемых моделей цену на 50% ниже on-demand, но экономить пришлось бы на центах. Счет AWS я не читал. Оценка выше - по тарифу, и средствами самой установки точнее ее не сделать: функция постобработки коннектора оставляет только вектор и отбрасывает inputTextTokenCount.
Расписания у повторной загрузки нет: ее запускает изменение источника, и у каждого источника свой признак. У плейбука это правка файла, у документации новый коммит, у MITRE обновление менеджера, после которого он отдает другой набор, у MISP свежий снимок манифеста. Поскольку идентификатор документа считается из данных, как сказано в разделе об источниках, повторный запуск на тех же данных ложится на те же _id; что при этом перезаписывается и что удаляется на изменившемся источнике, описано в разделе о поломках.
Неверный ответ разбирается по трем слоям: фрагменты, индекс, генерация. У каждого слоя свой признак, а у первых двух - еще и один запрос в Dev Tools, который отделяет слой от соседнего.
- Фрагменты. Признак: ответ агента уверенный, но в нем нет факта, который в документе есть. Запрос:
neuralс тем же вопросом и фильтромsource, как в разделе о запросах, только сtextв списке_source. Это проверка выдачи поиска по этому вопросу; вход модели она повторяет лишь приблизительно, потому что текст запроса к инструменту модель составляет сама. Если нужного факта нет и в этих пяти поляхtext, слой генерации ни при чем. - Индекс. Признак: среди пяти фрагментов ни одного из нужного документа. Запрос:
termпоdoc_idили поversionэтого документа. Пустойhitsозначает, что документа в индексе нет, и векторный поиск этого не покажет: контроль с молчаливым промахом выше вернул пять соседних фрагментов, а нужного документа среди них не было. - Генерация. Признак: факт есть в пяти полях
text, а в ответе его нет или он искажен. Запросы к индексу больше не нужны: здесь правят инструкцию агента или меняют модель, а подтверждением служит новый ответ, в котором факт из тех же пяти полейtextнаконец назван.
Чтобы снять оставшиеся оговорки, понадобились бы измерения, которых в этой статье нет:
- другой образ Indexer или другая версия, чтобы вывод о движке перестал держаться на одном образе;
- проба токенизации на руководстве на другом языке или на фиде с длинными JSON-атрибутами, чтобы размер фрагмента не опирался на одну страницу одного корпуса;
- сравнение сохраненного текста и векторов между двумя запусками загрузки, а не только идентификаторов, и замер того, куда ушли лишние минуты второй загрузки сверх пауз;
- второй вопрос по плейбуку с другой структурой разделов, чтобы увидеть, что возвращает шаг чтения за пределами плейбука из этой статьи;
- коннектор с отдельным системным полем, чтобы проверить, держится ли вывод о
prompt.prefixза пределами этого шаблона запроса.
Когда отдельное хранилище оправданнее индекса Wazuh
Вопрос, который стоит задать до выбора, скорее эксплуатационный, чем технический: кто будет владеть вторым сервисом. Отдельное векторное хранилище требует своей аутентификации и своего резервного копирования и держит вторую копию данных, а индекс внутри Indexer живет за тем же контролем доступа и по тому же адресу, что и алерты, и за вектором для него в Bedrock ходит сама база. Для корпуса такого размера, к которому и так обращаются через OpenSearch, второй сервис означает второго владельца и ничего не добавляет к поиску.
Три условия меняют ответ.
- Процессор и память Indexer уже заняты приемом алертов. Вызовы векторизации и k-NN поиск создают дополнительную нагрузку на тот же узел и начинают конкурировать с основной задачей SIEM.
- Важен сам движок: в этом образе, как показано в разделе о поломках, работает только
lucene, аfaissроняет узел на первой записи. - Корпус перерастает один узел.
Заключение
Ответ из введения теперь полный: агент дочитывает плейбук до конца и называет блокировку на 12 часов вместе с правилами, владельцем и условиями эскалации, потому что получает документ целиком. Тот же индекс из 7118 документов внутри Wazuh Indexer опрашивают одним гибридным запросом и curl, и MCP-сайдкар; событие с нужным хешем этот запрос ставил на первое место в оба измеренных дня, 2026-09-02 еще на предыдущей сборке индекса, а полная загрузка стоит несколько центов. Контроли оставили оператору две проверки перед тем, как верить ответу: свежий ли корпус, потому что по устаревшему модель отвечает с той же уверенностью, и есть ли нужный документ в индексе, потому что пятерка соседей приходит и без него.
Навигация по серии:
- Часть 1: ML Commons + Bedrock Connector
- Часть 2: OpenSearch MCP Server + Claude Desktop
- Часть 3: RAG с Titan Embeddings и k-NN (вы здесь)
- Часть 4: S3 Vectors и Bedrock Knowledge Bases