Какие части ответа теряются при смене хранилища
Аналитик первой линии спрашивает в середине инцидента одно: что предписывает наш runbook при переборе SSH против web-server-01. Полезный ответ обязан назвать шаг сдерживания, его параметр и источник, из которого это взято. Раздел Containment в плейбуке длиннее любого отрывка, который возвращает слой поиска, поэтому настоящий вопрос не в том, найдется ли плейбук среди первых пяти результатов, а в том, доедет ли до модели именно та его часть, которая отвечает.
Часть 3 оставила векторный индекс внутри Wazuh Indexer и назвала условия, при которых это неправильное место: когда важен движок векторного поиска, когда корпус перерастает один узел и когда загрузка алертов уже занимает процессор и heap этого узла. Здесь проверяется обратная сторона того же условия. Тот же корпус загружен в Amazon S3 Vectors через базу знаний Amazon Bedrock, ветка внутри Indexer пересобрана из того же снимка, и оба хранилища отвечали на один замороженный набор вопросов в один день.

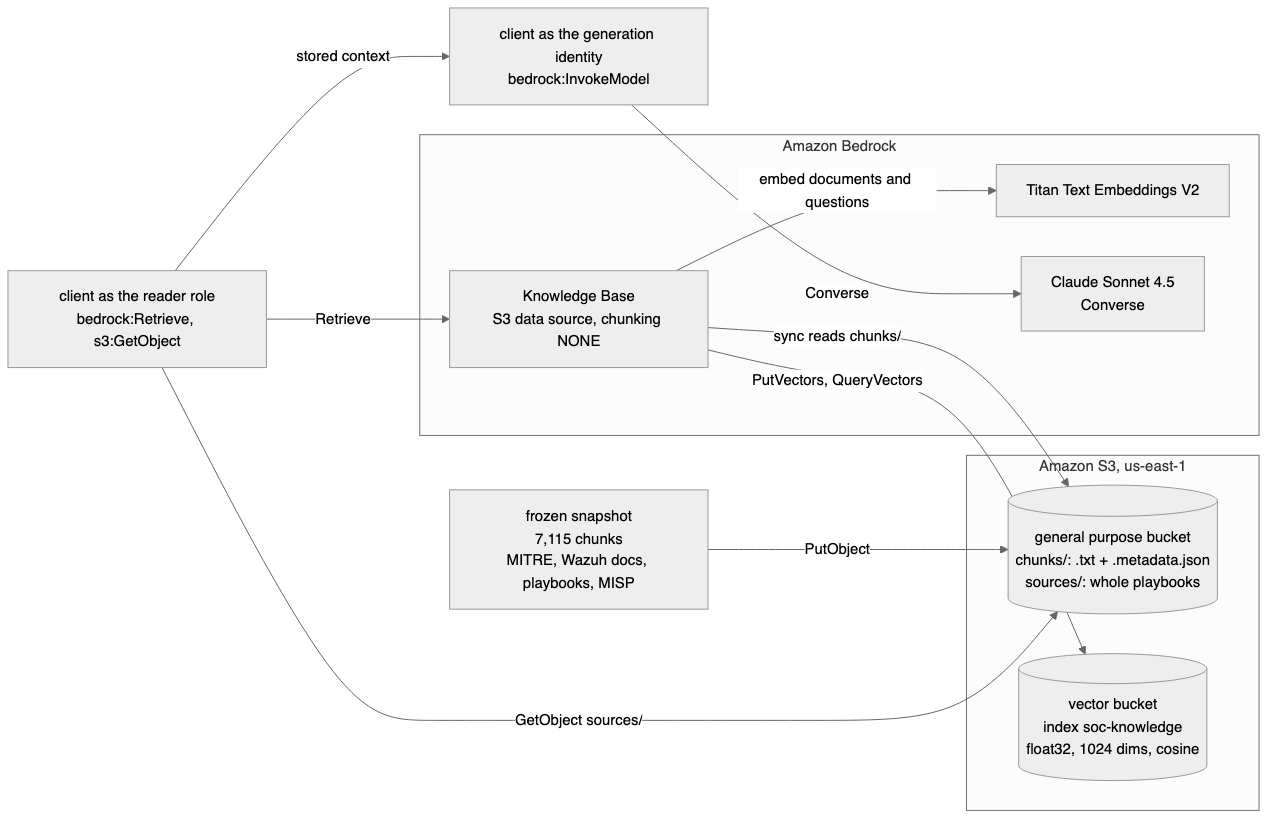
Измеренная установка: два bucket, база знаний между ними и две личности клиента, потому что поиску и генерации нужны разные разрешения
У серии четыре части.
- Часть 1 - ML Commons, коннектор Bedrock Claude и чат-агент в Wazuh Dashboard
- Часть 2 -
opensearch-mcp-server-pyкак сайдкар и Claude Desktop поверх MCP - Часть 3 - Titan Embeddings V2, индекс k-NN на движке lucene по четырем источникам и гибридный поиск
- Часть 4 (эта статья) - тот же корпус в Amazon S3 Vectors через Bedrock Knowledge Bases в сравнении с пересобранным индексом внутри Indexer
Все числа ниже получены 2026-09-11 и 2026-09-12 в регионе us-east-1, с одного клиента, на корпусе из 7115 фрагментов и 36 замороженных вопросах. Лаборатория удалена 2026-09-12, независимое перечисление аккаунта вернуло пустой список, поэтому повторить эти измерения без новой сборки нельзя.
Что именно сравнивается
Стенд части 3 перестал существовать: он демонтирован 2026-09-06 вместе с томами. Индекс на 7118 документов, который измеряла часть 3, остается историческим свидетельством, а не базой для нового сравнения, поэтому сравнение пришлось пересобирать, а не продолжать. Это первое, на что стоит заложить время при повторении.
Корпус захвачен один раз и пересобран офлайн: тело каждого источника загружено однократно и сохранено вместе с дайджестом, а фрагменты построены из этих байтов загрузчиками исходной лаборатории. Два повтора дали побайтово одинаковые файлы фрагментов. Размер фрагмента остался 3000 символов, перекрытие 200 - как в части 3, чтобы обе ветки резали текст одинаково и разницу в результатах нельзя было списать на разные границы.
Итоговый корпус - 7115 фрагментов: MITRE ATT&CK 1031, документация Wazuh 3851, плейбуки 24, события MISP 2209. В индексе части 3 было 7118. Три недостающих фрагмента - не ошибка подсчета, и следующий раздел именно о них.
Подготовка текстов и метаданных
Каждый фрагмент связан с источником через doc_id и несет пять пользовательских ключей метаданных. Через базу знаний бюджет составляет 1 КБ и 35 ключей на вектор, а самые объемные пользовательские метаданные пробной партии заняли 345 байт, то есть запас есть, но он не бесконечный.
Контроль превышения бюджета поставлен намеренно: два документа с метаданными в 1161 байт и 36 ключей. Задание загрузки отчиталось статусом COMPLETE, просканировано 25, новых 0, отказов 0, пропусков 0 - и оба документа проигнорировало. Единственным следом остался текст в failureReasons. Статус COMPLETE без отказов не означает, что проиндексирован каждый документ, и это правило дальше подтвердится вторым, менее очевидным способом.
Связь с полным документом существует отдельно от поиска. Плейбуки лежат в префиксе sources/ целиком, роль читателя берет их оттуда по doc_id фрагмента: 1906 символов, SHA-256 совпадает с захваченным файлом. Именно это, а не более удачный отрывок, закрывает разрыв между найденным фрагментом и разделом, который нужен аналитику.
Создание и проверка базы знаний
Хранилище - два bucket и одна база знаний. В bucket общего назначения лежат chunks/ с парой .txt и .metadata.json на каждый фрагмент и sources/ с целыми плейбуками. В vector bucket находится индекс soc-knowledge: float32, 1024 измерения, косинус. База читает префикс chunks/ с chunkingStrategy NONE, потому что корпус уже разрезан загрузчиком части 3, и повторное деление на стороне сервиса уничтожило бы ту самую сопоставимость, ради которой все это делается.
Сервисная роль создается раньше базы, которой она доверяет, поэтому доверие начинается с шаблона knowledge-base/* и сужается до точного ARN после создания базы. Между этими шагами есть гонка, на которую стоит заложить ограниченное ожидание: CreateKnowledgeBase, вызванный примерно через секунду после CreateRole, отказал с сообщением «unable to assume the given role», а тот же вызов в 17:35:51Z прошел с первой попытки. Это повод повторить запрос, а не искать ошибку в правах.
Полная загрузка просканировала 7118 документов и 7118 файлов метаданных, проиндексировала 7106 новых, не отказала ни разу и заняла 1929 секунд.
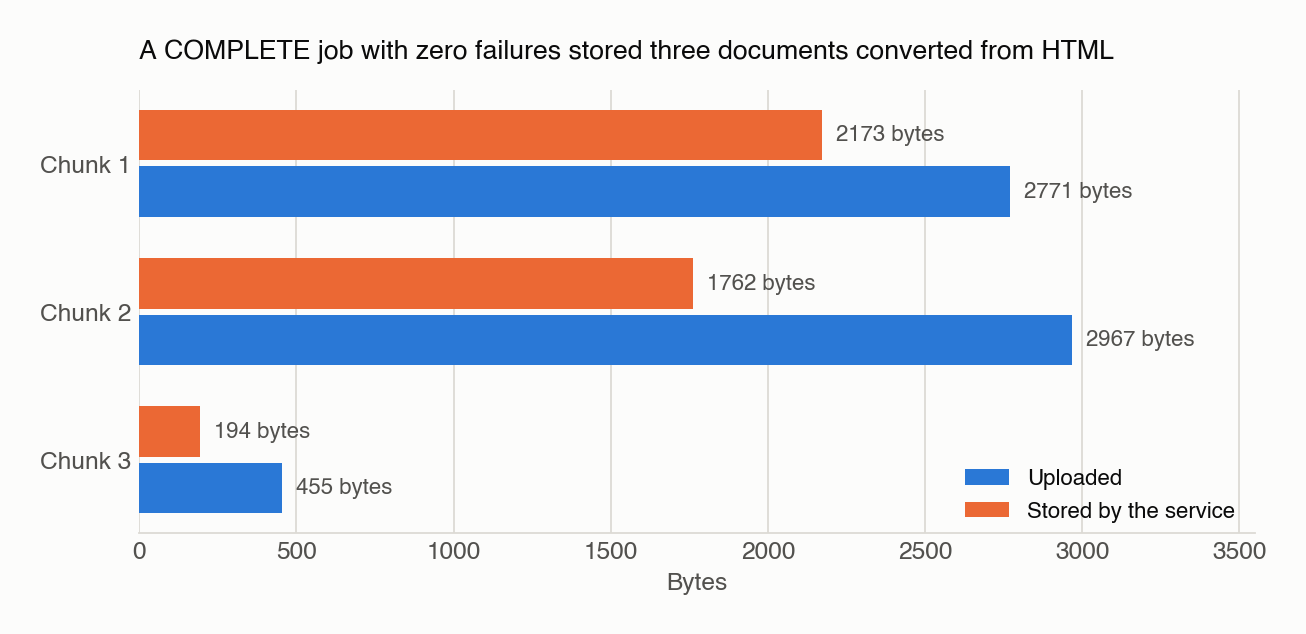
Затем я прочитал хранимый текст обратно, и три документа не совпали. Они были выгружены как .txt с Content-Type: text/plain; charset=utf-8, а сохранены как текст, преобразованный из HTML: теги удалены, переносы абзацев заменены пробелами, типографская кавычка стала прямой, появились обратные косые черты. Пример XML <reports> и заглушки в угловых скобках вроде <WAZUH_INDEXER_USERNAME> из хранимого текста пропали совсем. 2771 байт сохранились как 2173, 2967 как 1762, 455 как 194.

Что показало обратное чтение после задания со статусом COMPLETE и нулем отказов: три документа сохранены короче, чем были выгружены.
Эти три - ровно те фрагменты, в тексте которых есть строка <title. Из 1519 фрагментов, содержащих похожие на теги лексемы, изменились только они. Чтобы исключить коннектор S3, я загрузил те же три плюс 12 фрагментов пробной партии в отдельную базу через источник данных CUSTOM, передав текст встроенным содержимым. Хранимый текст вернулся байт в байт таким же, как в основном индексе, а все 15 векторов совпали с ним с косинусной близостью 1.0. Порядок преобразования и эмбеддинга эти прогоны не устанавливают: различить его можно было бы, построив эмбеддинг исходного и преобразованного текста и сравнив оба с хранимым вектором, а после удаления лаборатории векторов для такой проверки не осталось.
Документация говорит, что разбор по умолчанию обрабатывает текст файлов .txt, .md, .html и других текстовых форматов, но не описывает, как определяется тип, поэтому <title остается наблюдаемой корреляцией, а не документированным правилом. Я исключил эти три фрагмента из обеих веток. Корпус уменьшился с 7118 до 7115, ни один вопрос замороженного набора на них не опирается, а вторая синхронизация просканировала 7115 документов, удалила из индекса 3, показала 0 новых, 0 измененных и 0 отказов и закончила обратное чтение за 275 секунд.
Признак успешной загрузки для этого корпуса складывается из двух вещей: статистики задания и обратного чтения текста. По отдельности статус лжет в обе стороны.
Как читатель, MCP и Dashboard получают знания
Клиент ищет под ролью читателя с правами bedrock:Retrieve на базу знаний и s3:GetObject на sources/. Прав на модель эмбеддинга у него нет, и они не нужны: база строит эмбеддинг вопроса сама. Генерация идет под другой личностью, потому что Converse требует bedrock:InvokeModel, которого у роли читателя нет; все 33 вызова генерации выполнялись под операторским профилем. Один клиент, две личности - и на схеме выше они разделены именно поэтому.
На вопрос о сдерживании база вернула в первых пяти результатах два из шести фрагментов нужного плейбука, на первой и третьей позициях; остальные три - фрагмент другого плейбука и два фрагмента страницы документации про active response. Нейронный поиск внутри Indexer не вернул ни одного фрагмента плейбука: четыре фрагмента той же страницы документации и одна техника MITRE.
Ни одна из двух выдач не содержит раздел Containment целиком. С прочитанным полным документом модель ответила по существу: заблокировать адрес источника на межсетевом экране web-server-01 через active response firewall-drop на 12 часов, со ссылками на использованные отрывки. По пяти отрывкам базы знаний получился тот же ответ. По отрывкам нейронного поиска модель сообщила, что runbook для web-server-01 в контексте отсутствует, и это было точным утверждением о том, что ей передали.
Путь MCP из части 2 не переносится, и это стоит проверить до того, как строить на нем планы. Установленный сервер MCP (пакет 0.11.0, serverInfo.version 1.29.1, протокол 2025-06-18) отдает девять инструментов: ListIndexTool, IndexMappingTool, SearchIndexTool, GetShardsTool, GenericOpenSearchApiTool, ClusterHealthTool, CountTool, MsearchTool и ExplainTool. Все девять обращаются к OpenSearch, а GenericOpenSearchApiTool вызывает произвольный путь API OpenSearch, но не службу AWS, так что маршрута к базе знаний Bedrock среди них нет.
Значит, нужен собственный адаптер. Сервер лаборатории на официальном SDK работает по stdio и отдает один инструмент soc_knowledge_retrieve с параметрами question, source, version и k. На тот же вопрос о плейбуке он вернул клиенту SDK те же пять отрывков, что и прямой клиент; с фильтром source=playbook все пять пришли из плейбуков; недопустимое значение фильтра дошло до клиента как ошибка инструмента, а не как пустой результат, что и есть правильное поведение, когда имя фильтра устарело.
Путь Dashboard работает через ML Commons, и у него есть ограничение, которое решает, годится ли он вам. Коннектор aws_sigv4 с service_name bedrock на POST /knowledgebases/{id}/retrieve, подписанный временными ключами роли читателя вместе с session_token, удаленная модель и агент типа flow с MLModelTool отработали с первого раза: inference_results на месте, исполнение 1063 мс, те же пять отрывков. Но MLModelTool передает ответ Retrieve без обработки, поэтому агент возвращает JSON с retrievalResults, location и метаданными вместо ответа.
Две границы я не переходил: привязка к чату Dashboard и проверка в браузере не выполнялись, а временные ключи роли читателя живут один час, поэтому собранному так пути нужна история обновления учетных данных, прежде чем называть его рабочим.
Почему найденный сосед не подтверждает индикатор
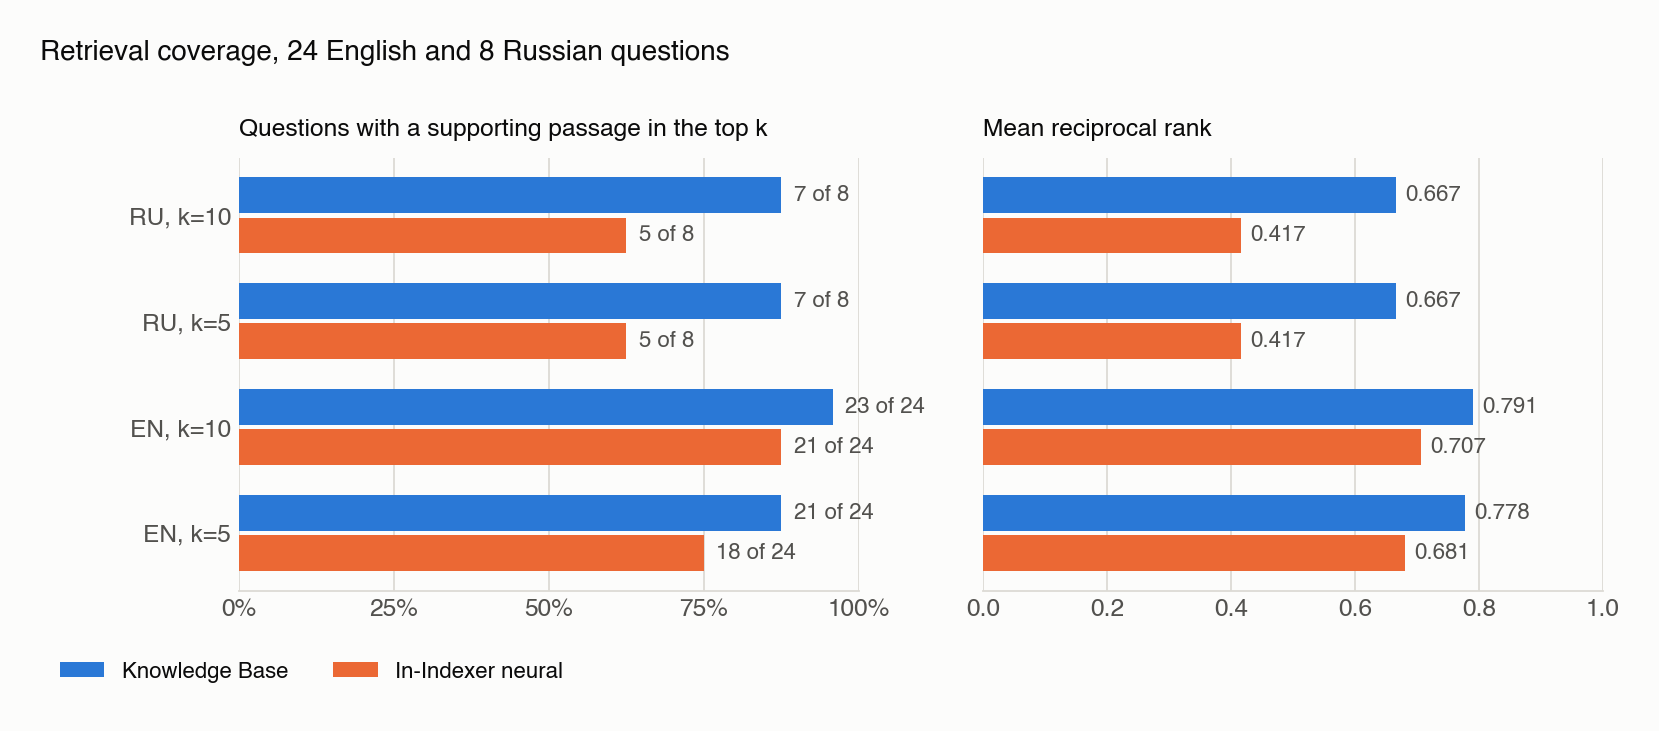
Покрытие - та метрика, которую переезд должен был улучшить, и он ее улучшил. На 24 английских вопросах при k=5 база знаний положила подтверждающий отрывок в первые пять для 21 вопроса при MRR 0.778 против 18 из 24 и 0.681 у нейронного поиска внутри Indexer. При k=10 вышло 23 из 24 (0.791) против 21 из 24 (0.707). На 8 русских вопросах разрыв шире и одинаков на обеих глубинах: 7 из 8 (0.667) против 5 из 8 (0.417).

Покрытие и MRR на замороженном наборе вопросов. База знаний выигрывает во всех условиях, а разрыв шире всего на русских вопросах.
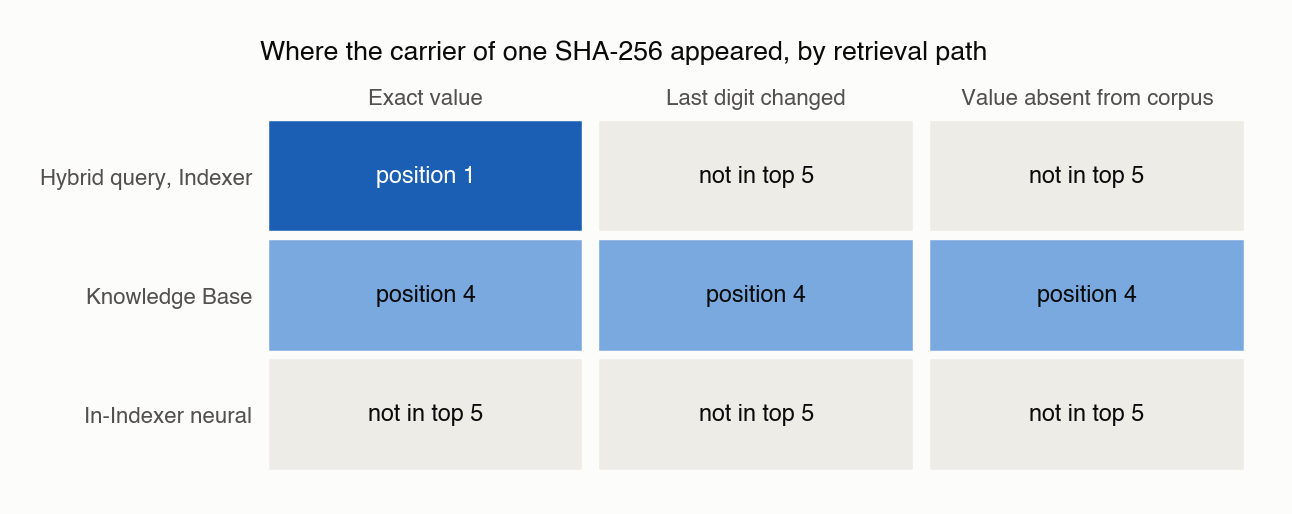
Контроль индикатора - место, где управляемое хранилище перестает быть равноценной заменой. Гибридный запрос части 3 находил фрагмент-носитель SHA-256 на первой позиции, и только для точного значения: для значения с измененной последней цифрой и для значения, которого в корпусе нет, носителя в его первых пяти не было. Это и есть нужное поведение, потому что для индикатора промах рядом - такой же промах.
База знаний вернула тот же носитель на четвертой позиции для всех трех значений: точного, похожего и отсутствующего. Она отвечает по теме вопроса, а не по значению, что равносильно отсутствию ответа. Нейронный поиск внутри Indexer не вернул носителя ни для одного из трех.

Один и тот же SHA-256, спрошенный тремя способами. Точное значение от промаха рядом отделяет только гибридный запрос.
Генерация это не спасает. Во всех шести контекстах индикатора модель ответила, что определить хеш по контексту нельзя, и для точного значения это было верно относительно переданного текста: индикатор записан только в поле метаданных indicators фрагмента-носителя - события MISP со 180 символами текста и 6 индикаторами, - а отрывки несут только текст. Хеш до запроса к модели не дошел ни разу. У семантического хранилища нет точного поиска, поэтому если рабочий процесс спрашивает, встречался ли вам этот хеш, условие term должно остаться где-то, где на такой вопрос отвечают.
Устаревший документ выглядит так же мирно. В контрольной базе лежали обе версии документации, 4.7 и 4.14, всего 23 фрагмента. Без фильтра первые пять - три фрагмента 4.14 и два 4.7, причем переименованная возможность попала с обеих сторон: vulnerability-detection на втором месте с оценкой 0.7932 и vulnerability-detector на третьем с 0.7852, а все пять уместились в полосу 0.7591-0.7946. Оценка не отделяет действующий документ от замененного. С фильтром version=docs-4.14 все пять пришли из 4.14, с version=docs-4.7 - все пять из 4.7. Разделяет их фильтр по метаданным, а не ранжирование.
Отсутствующий источник проверяется парно к предыдущему: корпус заменен на 1098 фрагментов, в которых ответа нет, вопрос тот же. Ни один из первых пяти не содержит ни старого, ни нового имени возможности, а оценки лежат между 0.7546 и 0.7945 - в той же полосе, что и в прогоне, где ответ был. Отсутствие не выглядит как низкая оценка, и это самое полезное знание перед тем, как доверять порогу.
Разграничение доступа отработало: роль читателя с правом Retrieve только на основную базу получила AccessDeniedException на контрольной, генерация при этом не вызывалась.
Что происходит после правки или удаления документа
Правка одного фрагмента и удаление другого с последующей синхронизацией дали 1 измененный и 1 удаленный документ без отказов, а обратное чтение по оставшимся 1097 фрагментам подтвердило, что хранится новый текст. Повторная синхронизация без изменений показала 0 новых, 0 измененных и 0 удаленных.
Удаление стоило трех попыток. Источник данных с политикой dataDeletionPolicy DELETE снимает свои векторы постепенно, пока показывает статус DELETING, и на этом корпусе получалось около 46 векторов в минуту: в контрольном индексе через три минуты оставалось 352 из 1121, в основном через час - 4283 из 7115. Два ограниченных ожидания, 900 и 3600 секунд, на этом исчерпались. Удаление самого индекса сняло оставшиеся 4283 вектора сразу, но оно же вынуло хранилище из-под идущего удаления, и источник, а за ним база знаний перешли в состояние DELETE_UNSUCCESSFUL. Выход сервис называет сам, в failureReasons: перевести dataDeletionPolicy в RETAIN и повторить. После этого источник исчез примерно за пять минут, база знаний - еще за пять.
Итог очистки: удалены три индекса, vector bucket, bucket документов с 16428 объектами и четыре роли, а независимое перечисление аккаунта не нашло ни одного имени лаборатории.
Сколько стоит запрос и откуда берется задержка
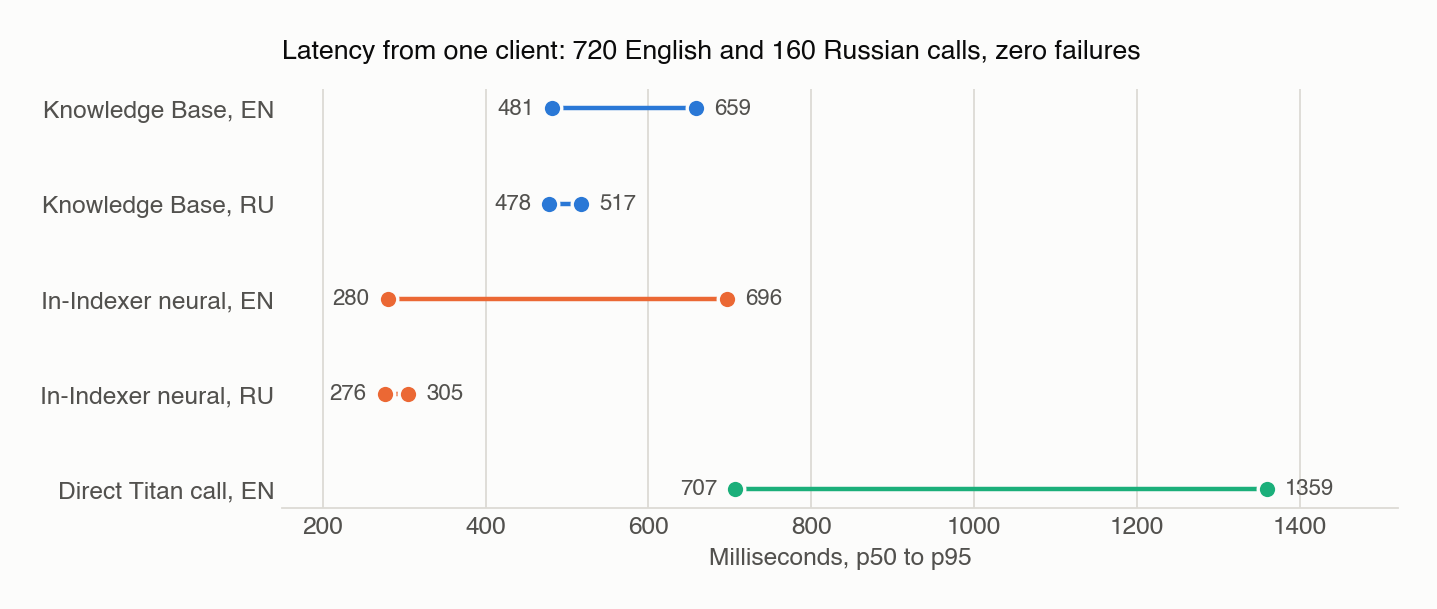
Задержки измерены на английской серии при k=5: 24 вопроса, 10 повторов после 3 прогревов, 0 отказов из 720 вызовов. База знаний дала p50 481.4 мс и p95 658.8 мс, нейронный поиск внутри Indexer - p50 279.7 мс и p95 696.4 мс. На русской серии из 8 вопросов и 160 вызовов вышло 477.8 и 517.1 против 276.0 и 304.9. Сравниваются две установки, а не два алгоритма: база знаний - это сетевой вызов в us-east-1, а Indexer стоял рядом с клиентом.

Задержки с одного клиента. База знаний - это вызов в us-east-1, а Indexer стоял локально, поэтому сравниваются установки.
Одно число я объяснить не могу. Прямой вызов Titan с того же клиента, строящий эмбеддинг того же вопроса, занял p50 706.7 мс, то есть оказался медленнее Retrieve базы знаний, который сам строит эмбеддинг вопроса и только потом ищет. Привожу как наблюдение, а не как объясненный результат.
Весь эксперимент обошелся в 0.46-0.75 USD по receipts: эмбеддинги Titan 0.04-0.09 на 2.11-4.44 млн токенов для обеих веток, контрольной базы и пробы; запросы PUT к S3 0.08; чтения S3 0.02; запись в S3 Vectors 0.01-0.22 за 8255 векторов; генерация 0.31-0.34 в зависимости от применимого тарифа Claude. Запросы поиска не добрали и 0.01, за удаление ресурсов платы нет.

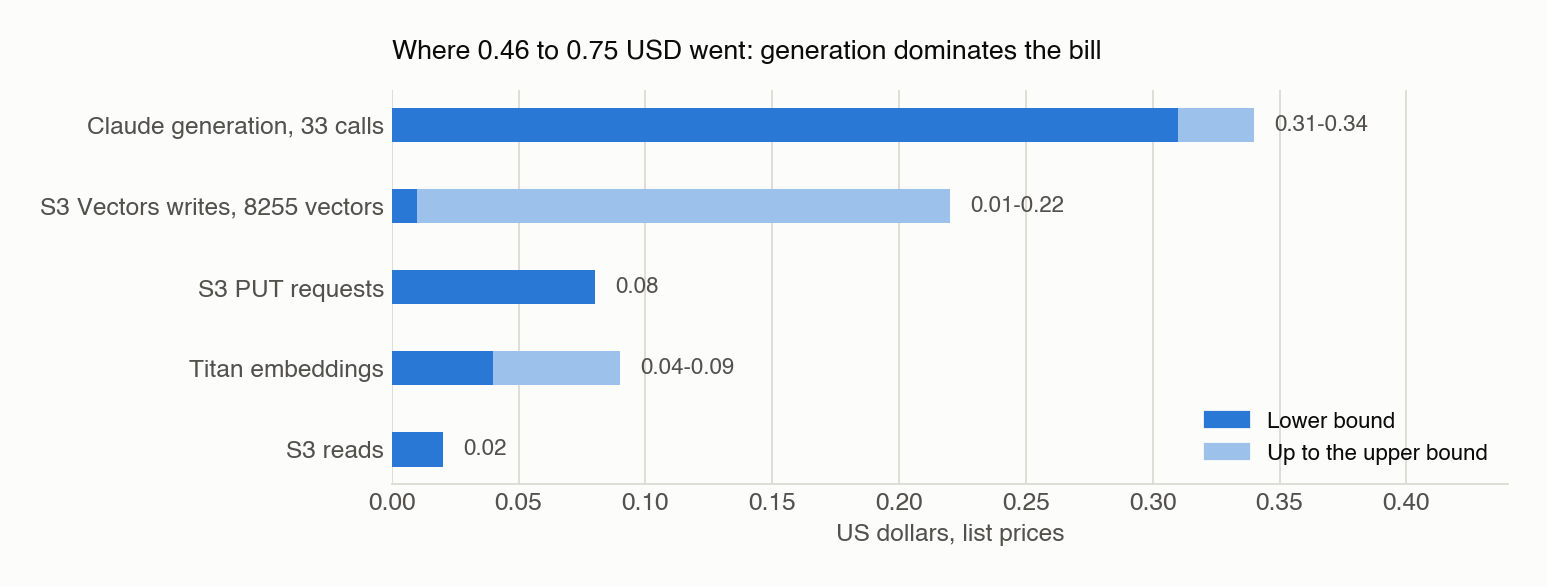
В этой сумме доминирует генерация, причем с большим отрывом: 33 вызова при temperature 0 и maxTokens 800 дали 71595 входных и 6505 выходных токенов. Хранение и поиск - дешевая часть базы знаний, счет выставляет модель.
Temperature 0 не сделала ответы воспроизводимыми. Три повтора совпали дословно только в одном контексте из одиннадцати, а число выходных токенов менялось вместе с текстом: 194 и 310 в двух повторах одного контекста. Если вы собираетесь сравнивать ответы модели между прогонами, это стартовый уровень шума.
Выносить корпус наружу стоит тогда, когда не хватает именно семантического покрытия, когда не хочется, чтобы эмбеддинг и k-NN спорили за heap одного узла с загрузкой алертов, и когда управляемое хранилище с фильтрами по метаданным на каждый вектор оправдывает сетевой перелет примерно в 200 мс относительно локального индекса. Оставлять внутри стоит тогда, когда вопросы задаются о значениях, а не о темах: точный путь для индикатора существует только там, где есть условие term, а у базы знаний на S3 Vectors его нет.
Честный ответ для SOC в том, что это два хранилища с разными задачами, и стоимость семантического здесь измерена: 0.46-0.75 USD на корпус из 7115 фрагментов, то есть достаточно мало, чтобы выбор редко упирался в деньги.
Одно правило действует для любого из двух хранилищ, и писать его я не планировал: задание загрузки со статусом COMPLETE и нулем отказов не доказывает, что в индексе лежит то, что вы выгрузили. Читайте хранимый текст обратно и читайте failureReasons даже тогда, когда ничего не упало.